庆北国立大学:让LLM当损失调音师,图像恢复PSNR最高涨3.35
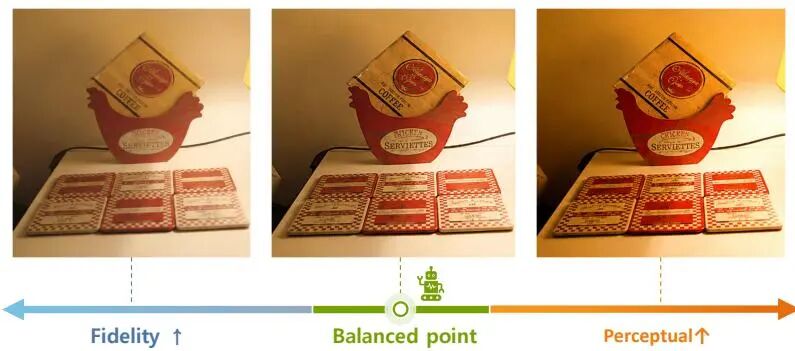
调损失权重这件事,以往基本靠炼丹手感和几轮消融碰运气。这篇论文干脆把LLM塞进训练循环:每隔一段拿固定小样本跑一遍质量指标,让它的下一段训练自己决定该更看重保真,还是更好看。改的全是现成损失项,网络结构、优化器、数据管线、推理流程一个没动,训练额外开销不到0.2%,推理零成本。三个恢复任务、七个基准,都挪到了更划算的平衡点上。🤨
LONGGE AI RESEARCH DAILY
每天筛选值得关注的 AI 论文,用工程视角拆解方法、实验和真正的落地价值。
目前已发表 1811 篇文章
调损失权重这件事,以往基本靠炼丹手感和几轮消融碰运气。这篇论文干脆把LLM塞进训练循环:每隔一段拿固定小样本跑一遍质量指标,让它的下一段训练自己决定该更看重保真,还是更好看。改的全是现成损失项,网络结构、优化器、数据管线、推理流程一个没动,训练额外开销不到0.2%,推理零成本。三个恢复任务、七个基准,都挪到了更划算的平衡点上。🤨

无线胶囊内镜拍出来的图常常模糊不清,而真实场景下几乎不可能拿到一一配对的清晰与模糊图对。这篇来自印度SVNIT与挪威NTNU的工作把Transformer放进无监督GAN里做四倍超分,还顺手提出了一个内镜专用的无参考画质指标,代码与预训练模型均已开源,值得做医学影像增强的读者仔细看看。

扩散模型做超分,画质确实顶,训练也确实是出了名的“百万步起步”。这篇文章没动网络结构,只在训练目标里加一个冻结VGG的感知正则项,就能让脑MRI和彩色人脸超分稳定加速收敛,局部细节还更真。想低成本给扩散训练“加外挂”的读者,值得花三分钟读完。

刷短视频时,原图里正常的人脸经过平台"画质增强"后,可能变得僵硬或文字扭曲。这是平台在后台对用户生成内容(UGC)进行压缩、编码、解码、再增强的结果。

人人都说“先增强,后感知”,但一篇来自高中生的树莓派论文硬核证明:这个“共识”可能正在浪费你80%的算力!用10毫秒的暗通道判断,直接省掉470毫秒的去雾推理,精度还不降反升。嵌入式视觉的极致性价比,这篇论文讲透了。

拍完夜景想发朋友圈,结果暗部一团黑、亮部还偏色?这篇新南威尔士大学的工作把分块扩散模型玩出了新花样:分块尺寸随时间步渐进增大,既保住局部细节又协调全局亮度,4K图像推理提速80倍,显存仅需8.8GB,简直是低光增强领域的"效率控"福音。

拍完照片,别人看主角还是背景杂物?调亮度、加对比度、局部压暗……折腾半天,效果不佳。

拍照一时爽,后期火葬场——尤其拍到过曝夜景人像,想从高光里捞细节时,灵魂拷问就来了:先降噪还是先调亮度?先调亮度吧,暗部噪点会被放大;先降噪吧,过曝区域的细节又未必救得回来。传统玩法无非这两种,顺序任选,各有代价。

把软直方图和扩散滤波硬凑成一对,居然在高斯+脉冲混合噪声上打出了漂亮的组合拳。方法推导干净利落,没有堆砌花活,适合想从变分视角理解鲁棒去噪底层逻辑的读者花十分钟读一读。

聊超分绕不开一个千古难题:又想马儿跑得快(细节丰富、观感锐利),又想马儿不吃草(结构保真、贴合原图)。这两件事在底层视觉里长期互相打架,逼着研究者要么偏科要么和稀泥。

一张照片拍完就定型了?南京大学最新研究告诉你:换视角、拉焦距、调色温、改曝光,一张图就能“重拍”出各种效果,还跟真重新拍过一样。首个统一框架ReX-Shot,直接把单图三要素控制一次搞定。

水下照片总是蓝绿蒙蒙一片?印度理工学院这次把海洋光学的"家底"全搬进了合成数据——十种Jerlov水体、深度依赖辐照度、生物荧光一次建模到位。合成数据FID比最强竞品直降46%,四个增强架构跨六个真实数据集全面反超。搞水下视觉的朋友,这份物理知识+数据工程的双拼值得仔细品品。
LONGGE AI COMMUNITY
加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。
加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。
 微信扫码加入知识星球