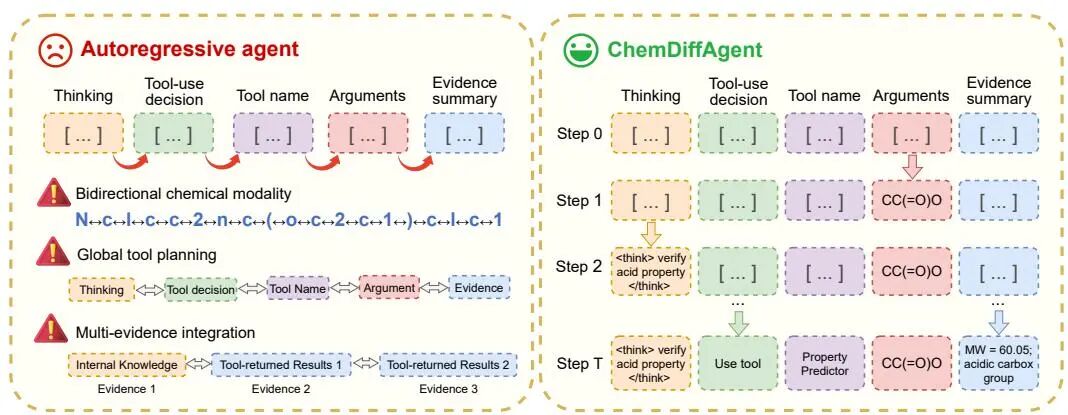
中科院计算所提出ChemDiffAgent:8B化学智能体反超GPT-5.5
化学智能体这几年做得不少,但几乎都押在自回归这条路上:一个token一个token从左往右吐,工具名、参数、SMILES谁先谁后,全被钉死。这篇论文干脆把化学推理整体改成掩码扩散的迭代去噪,让工具名、参数和推理过程在同一个块里一起收敛。结果是一个8B模型六类化学任务总分91.8%,反超GPT-5.5,还直接开源了。
LONGGE AI RESEARCH DAILY
每天筛选值得关注的 AI 论文,用工程视角拆解方法、实验和真正的落地价值。
目前已发表 1811 篇文章
化学智能体这几年做得不少,但几乎都押在自回归这条路上:一个token一个token从左往右吐,工具名、参数、SMILES谁先谁后,全被钉死。这篇论文干脆把化学推理整体改成掩码扩散的迭代去噪,让工具名、参数和推理过程在同一个块里一起收敛。结果是一个8B模型六类化学任务总分91.8%,反超GPT-5.5,还直接开源了。
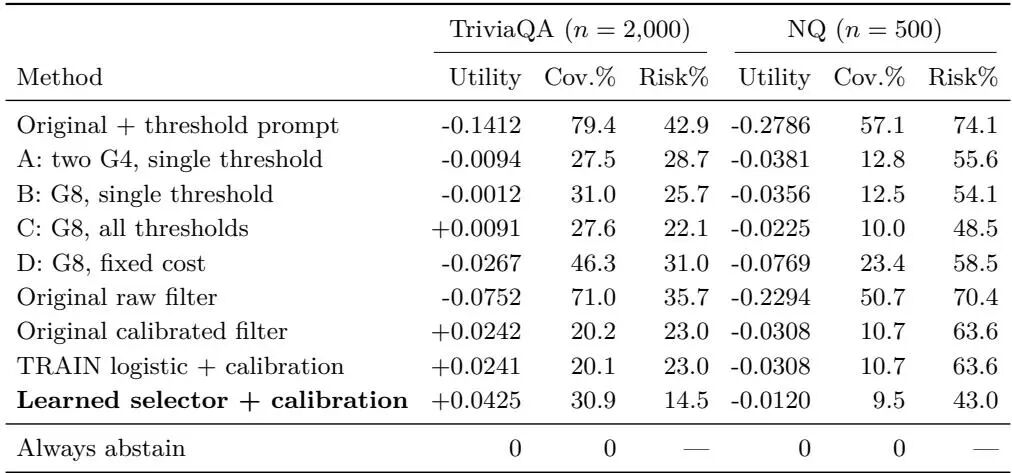
先讲一个大家都踩过的坑。你问一个模型某个偏门的事实问题,比如某本小众小说里配角的全名,或者某个 1998 年的会议在哪座城市举办,模型张口就来,语气笃定、句式工整、标点齐全——一查,全是编的。
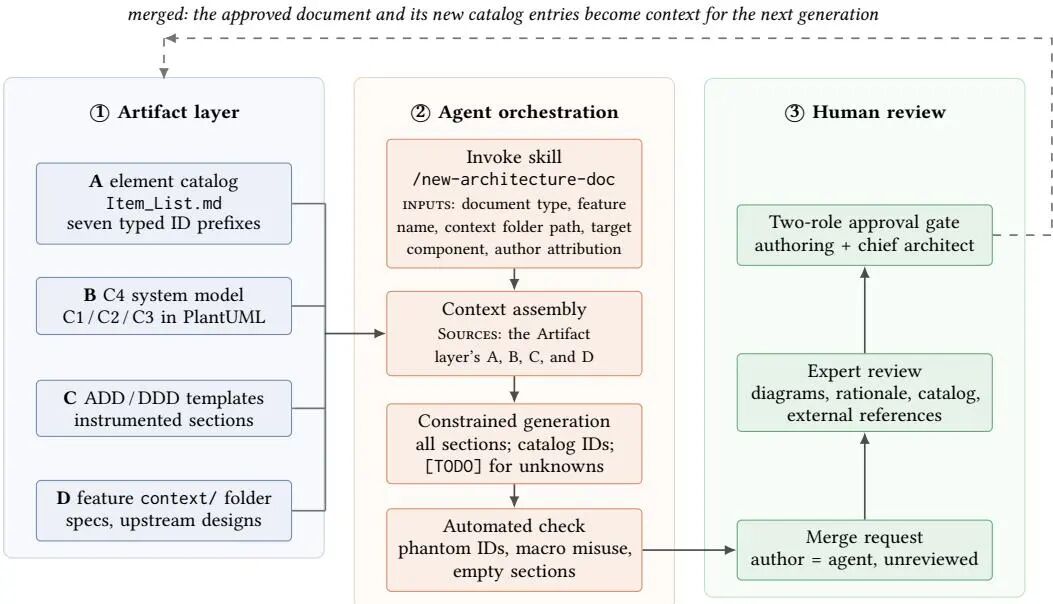
这个不对称其实很好解释。代码能编译就是能编译,编译不过就是过不去,对错有硬反馈,智能体可以在里面反复试错。
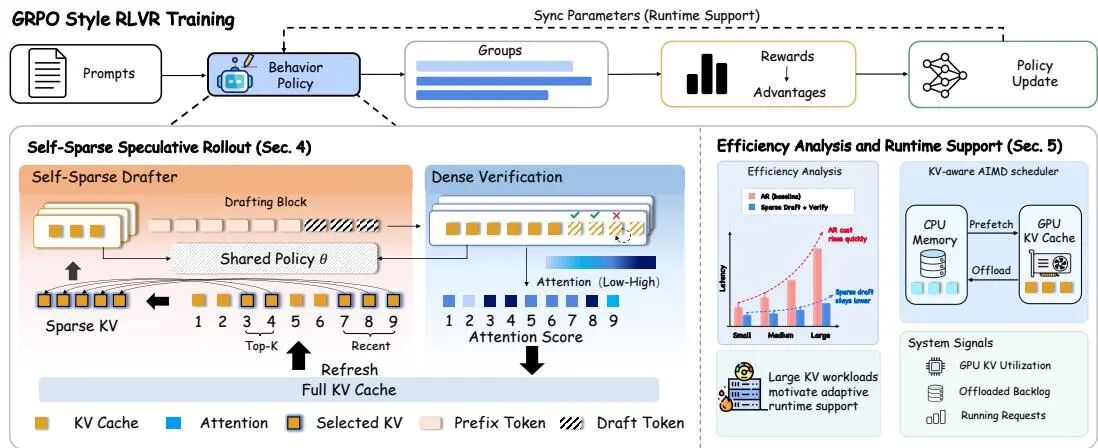
大模型做强化学习,真正的瓶颈常常不在反向传播,而在 rollout 生成——注意力吃掉了七成以上的解码时间。港科大(广州)这篇 S3R 的做法挺取巧:稀疏注意力只负责"提词",全注意力负责严格验收,采样分布不动,KV 读取却大幅减少。Qwen3-1.7B 上端到端训练吞吐做到 1.39 倍,训练还更稳。
AI 这次不写代码,改去啃数学硬骨头:中心荷 c=8、实现 Haagerup 双重 Z(ℋ₃) 的顶点算子代数被显式构造出来。更值得看的是过程账本——Astra 6 找了 3 小时 22 分,Sol 6.1 想了 1 小时 6 分给出证明。结论仍待社区复核,但这份 AI 参与数学发现的一手记录,本身就稀有。
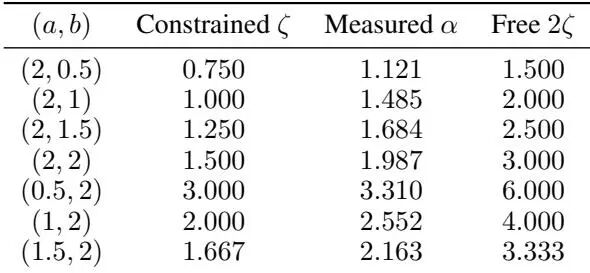
这篇论文回答的是缩放定律里最朴素也最要命的一个问题:多加一层,为什么有用?作者的答案有点反常识——在线性注意力里,深度只能按数据谱的幂律慢慢挤性能,很快就见底;注意力一旦带上 softmax 非线性,损失就按约 1/L 的逆幂律继续往下掉。作者还把这件事接到中心极限定理上,把「层间共享误差」和「层间差异」分开算账。
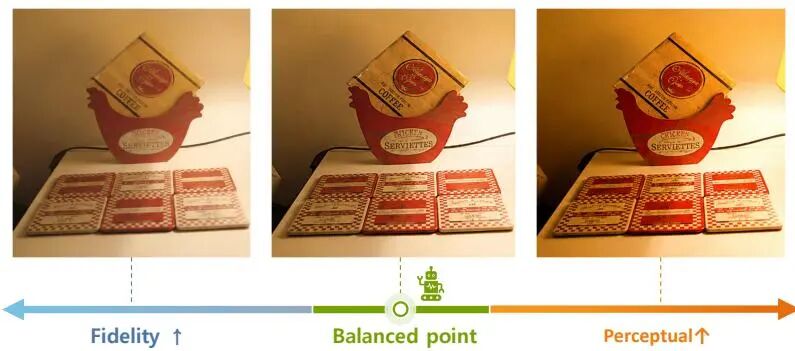
调损失权重这件事,以往基本靠炼丹手感和几轮消融碰运气。这篇论文干脆把LLM塞进训练循环:每隔一段拿固定小样本跑一遍质量指标,让它的下一段训练自己决定该更看重保真,还是更好看。改的全是现成损失项,网络结构、优化器、数据管线、推理流程一个没动,训练额外开销不到0.2%,推理零成本。三个恢复任务、七个基准,都挪到了更划算的平衡点上。🤨
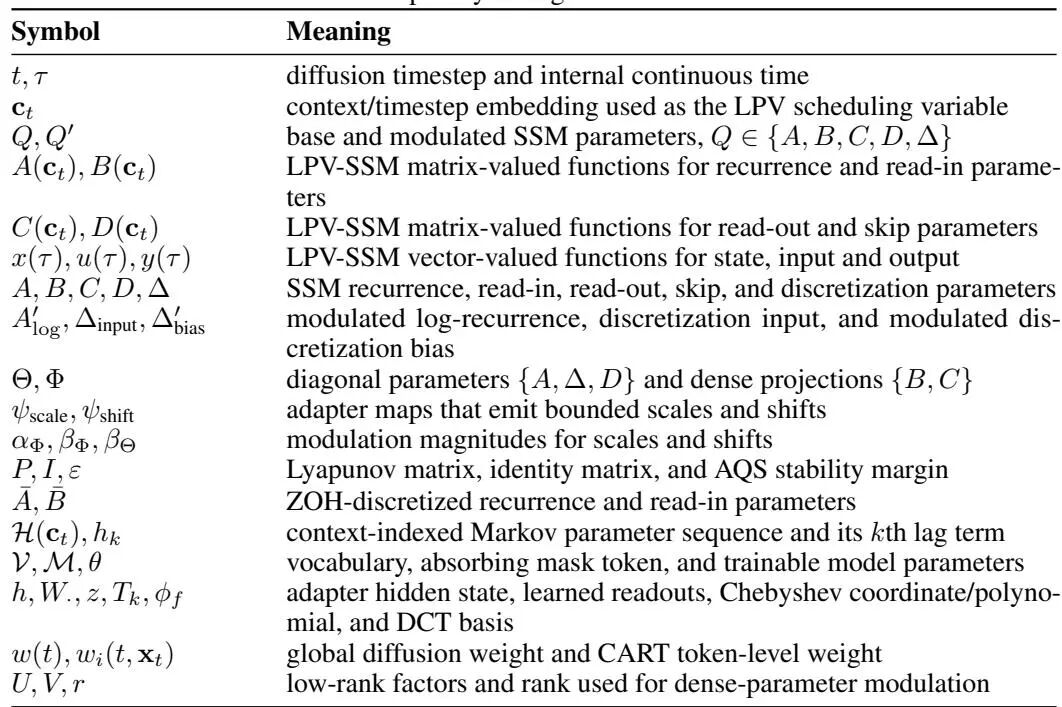
条件化这件事,主流做法要么把上下文塞进输入,要么用AdaLN去调激活,本质都是在外围打补丁。香港城市大学和英伟达AI技术中心这篇,直接把扩散时间步映射成SSM递归参数A、B、C、D、Δ的有界偏移,冻结111M骨干只训6.3到11M适配器,Chebyshev核平均验证损失压到2.55,还附送一份解析稳定性证书。能把"为什么稳"讲清楚的参数高效微调,不太多见,值
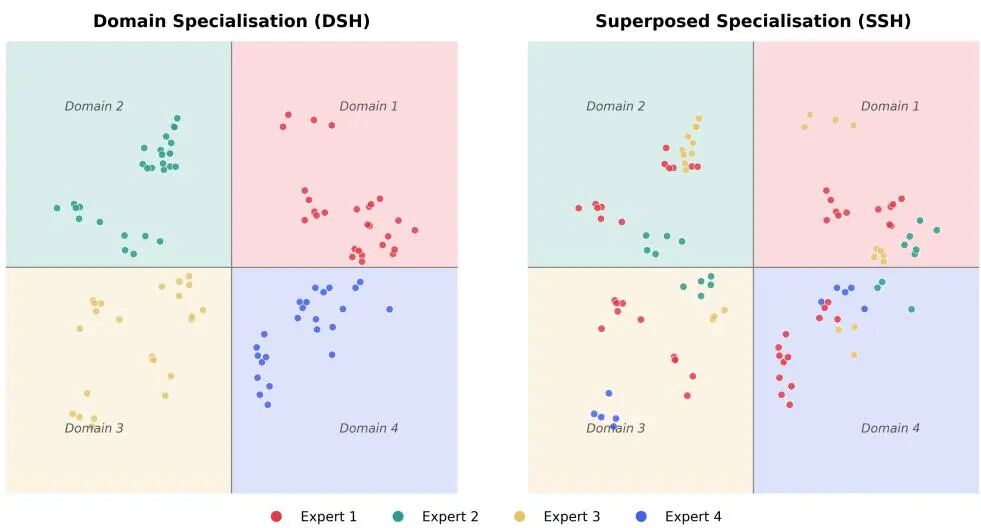
MoE模型火了好几年,可「专家到底在干嘛」一直没人说清。主流解释是每个专家管一个领域,但真去翻,翻不出来。维也纳工大等提出RouterInterp,用稀疏自编码器给出另一种答案:专家干的是「多份不相关特征的叠加活儿」。这个结论有点反直觉,但证据挺扎实。
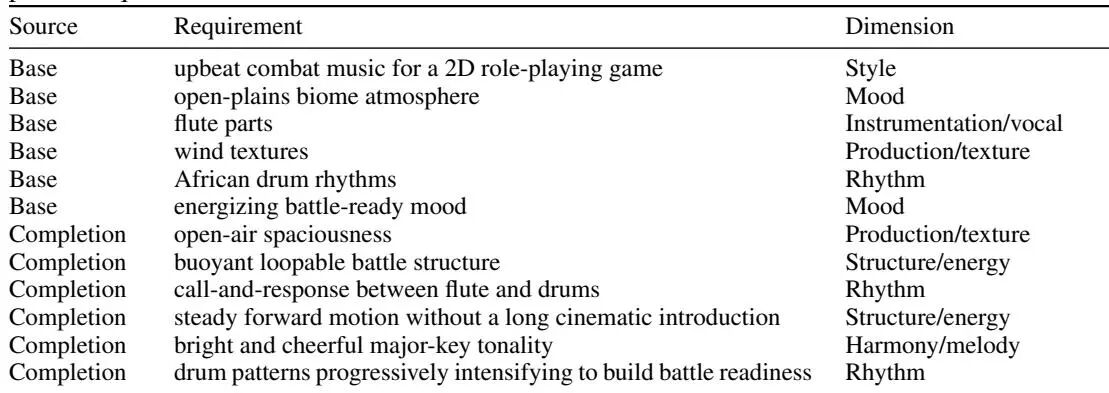
"来一段像 RPG 最终 Boss 战那样的音乐,钢琴开场,三十秒之后弦乐进来,情绪从压抑慢慢转到悲壮。"
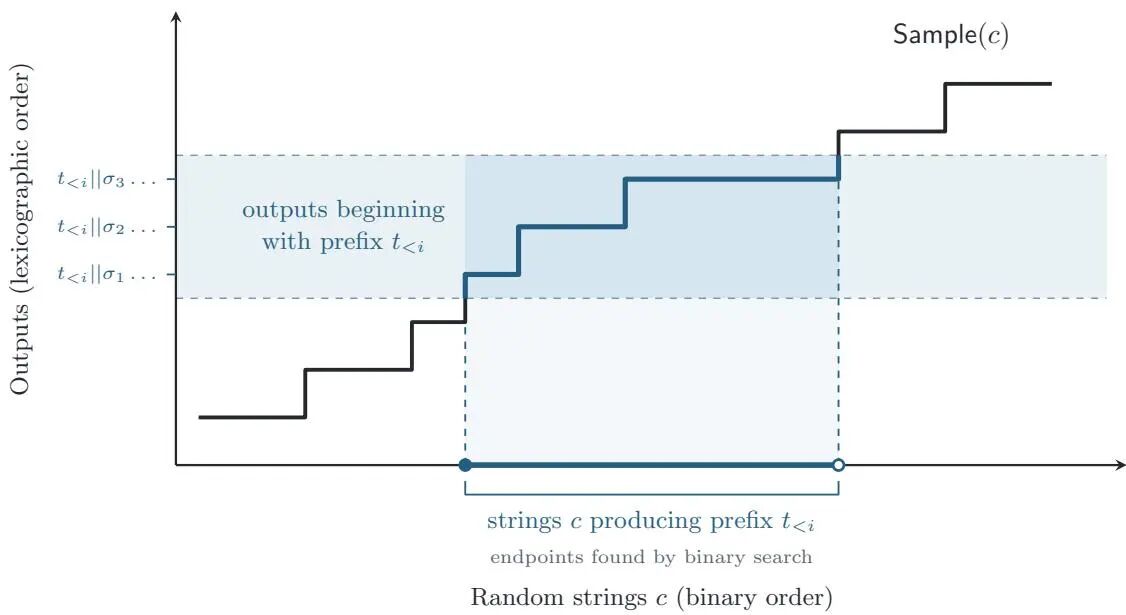
"压缩即智能"这句话流传了很多年,但一直停留在直觉和实验结果上。这篇论文第一次把它写成了定理:语言模型和单调压缩是等价的,误差只差2比特;而一旦去掉"单调"这个条件,等价关系就崩了,除非某个密码学假设不成立。
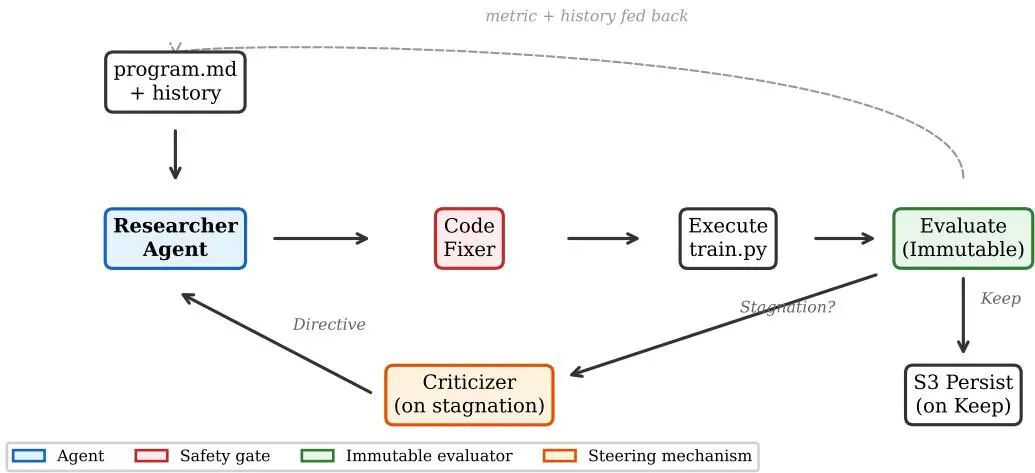
把AutoResearch放进真实生产流水线跑满12周是什么体验?亚马逊给出了答案:220多次实验、多GPU连续烧钱,换来1.82倍和2.1倍的指标提升,也换来五种翻车模式的完整记录,还顺手让代理自己补上了5.8倍的目录覆盖缺口。自主科研的真实边界在哪里,这篇值得花时间读。
LONGGE AI COMMUNITY
加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。
加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。
 微信扫码加入知识星球