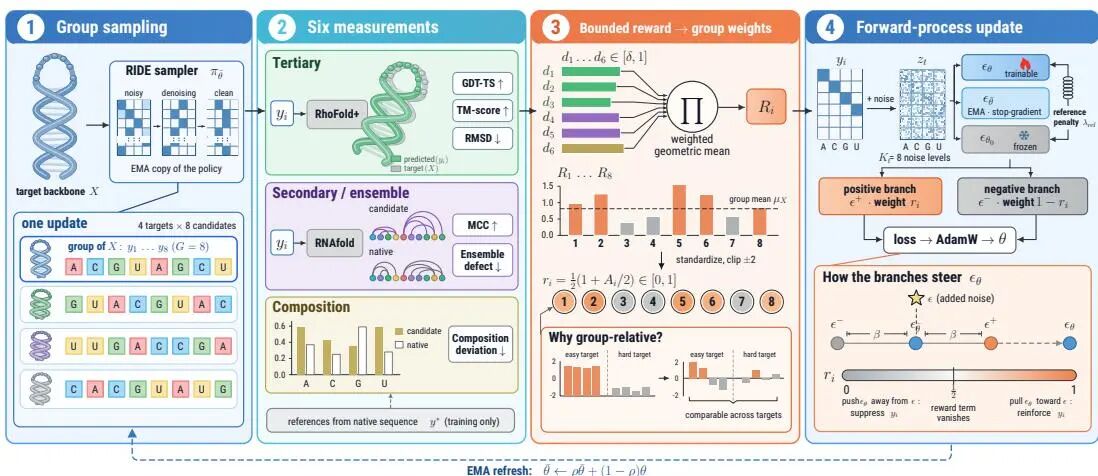
复旦大学MORAD:六维奖励让RNA逆设计GDT-TS涨16.0%
RNA逆设计是先定三维结构,再找能折叠成该结构的序列。
LONGGE AI RESEARCH DAILY
每天筛选值得关注的 AI 论文,用工程视角拆解方法、实验和真正的落地价值。
目前已发表 1811 篇文章
RNA逆设计是先定三维结构,再找能折叠成该结构的序列。
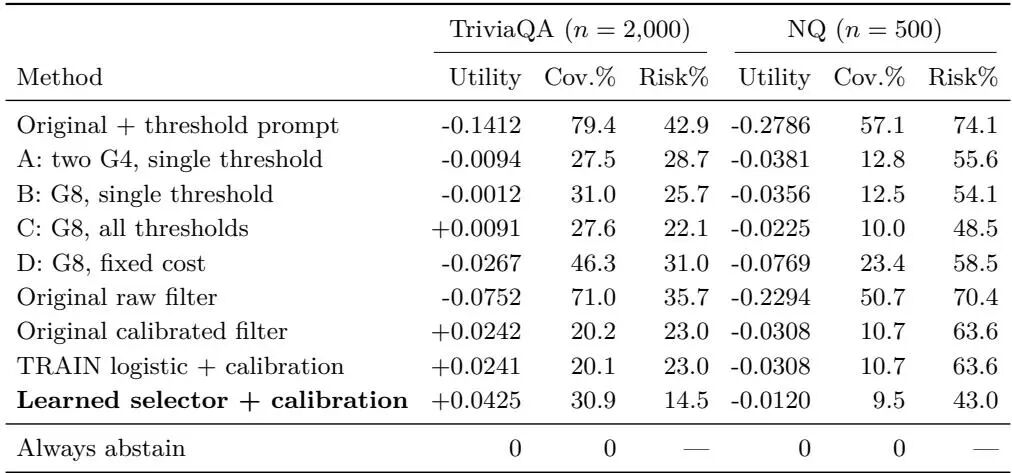
先讲一个大家都踩过的坑。你问一个模型某个偏门的事实问题,比如某本小众小说里配角的全名,或者某个 1998 年的会议在哪座城市举办,模型张口就来,语气笃定、句式工整、标点齐全——一查,全是编的。
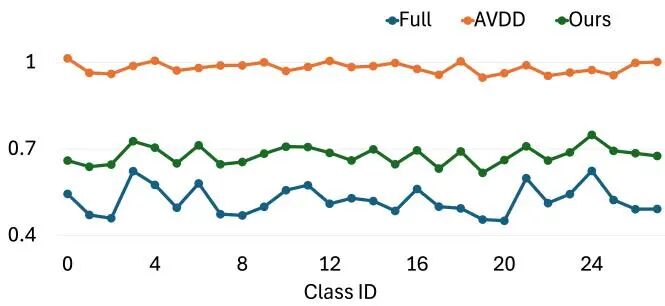
数据集蒸馏这名字听着很美:用一小撮合成样本,顶掉整个大训练集。可一到音视频这种双模态场景,就撞上两根硬钉子——显存炸裂,以及两个模态各说各话。印度理工海得拉巴分校这篇 X-AVDD 用双向交叉注意力把两件事一起收拾了:合成时间从10小时压到1.3小时,VGGSound 上的准确率从个位数跳到两位数。这波值得拆开看看。
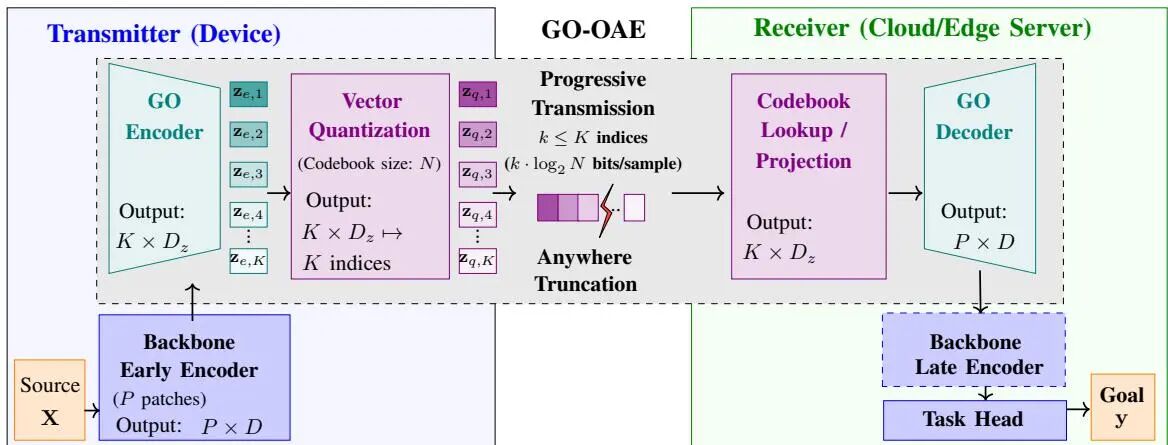
想象一个场景:无人巡检车在隧洞中运行,摄像头拍摄画面,信道抖动导致带宽骤降。视频链路降码率,画面模糊,而接收端的识别模型仍需回答轨道上是否有人。
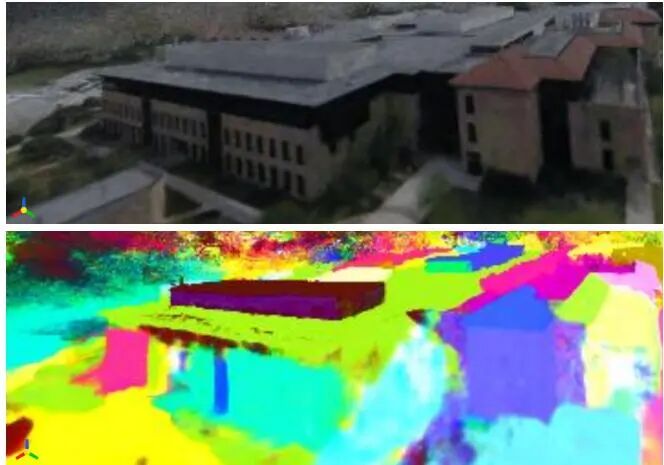
一栋楼站在那儿,几十米高,几千个构件。想把它搬进电脑,常见做法是让无人机绕着飞一圈拍上千张照片,再交给算法重建三维模型。
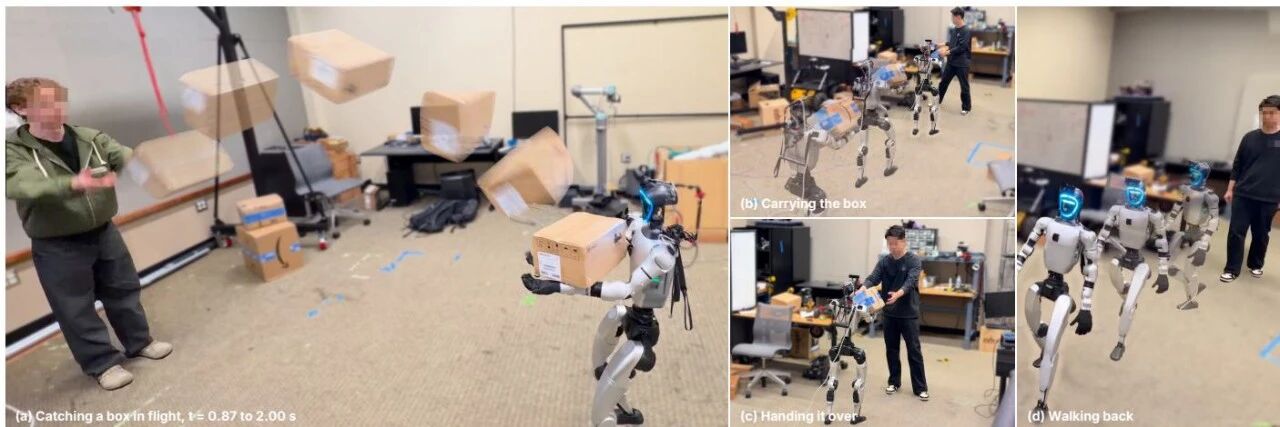
接住一个扔过来的东西,人类基本不用想。回追一个网球、接住从桌边滑落的杯子、侧身躲开推车、搬货时顺手接住同伴抛来的纸箱,这些动作有一个共同点:目标在动,留给你的反应时间大约只有一秒,而且要用整个身体去接,而不只是伸手。
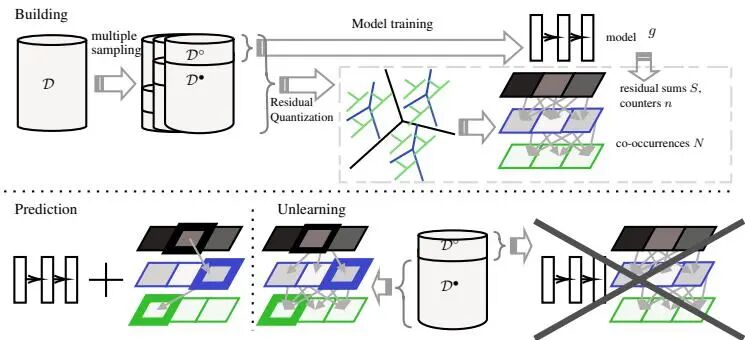
法规给了用户"删除权",可模型不会说忘就忘——过去想精确抹掉一个样本,基本只能重训。Meta这篇把模型拆成冻结的骨架和可加的内容,删除直接退化成算术减法,低类别数任务上期望延迟比SISA快483倍,还做到与重训比特级一致。值得花时间读。
一个可视化平台宣称自己算出来的数字和手写脚本一样,这话到底该不该信?Nimbus BCI 给出的答案是:六条经典脑电解码流水线,三个公开数据集,两种评估协议,平台引擎与独立手写实现各跑一遍,逐被试比准确率。确定性流水线全部 0.00 点一致,深度模型的差异落在训练种子噪声里。软件平台自己做验证研究,这事本身就少见,值得看一眼它的验证设计和边界。
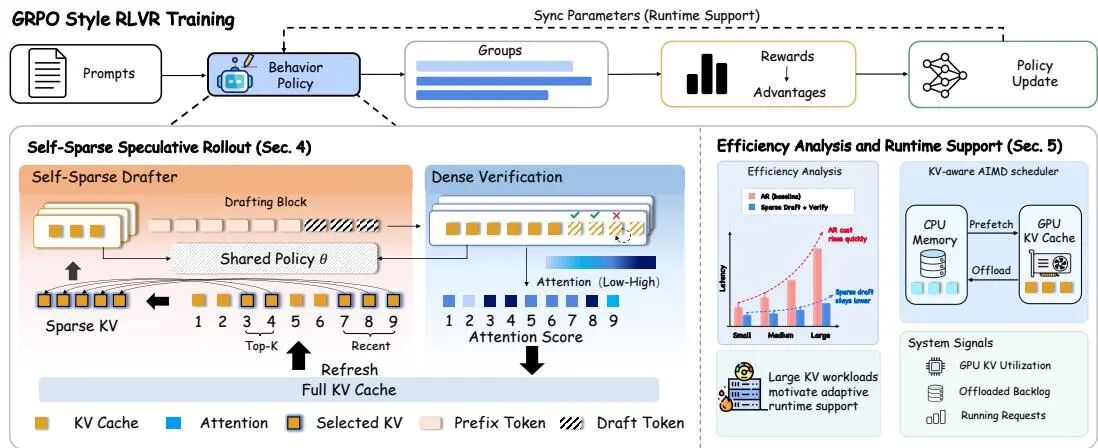
大模型做强化学习,真正的瓶颈常常不在反向传播,而在 rollout 生成——注意力吃掉了七成以上的解码时间。港科大(广州)这篇 S3R 的做法挺取巧:稀疏注意力只负责"提词",全注意力负责严格验收,采样分布不动,KV 读取却大幅减少。Qwen3-1.7B 上端到端训练吞吐做到 1.39 倍,训练还更稳。
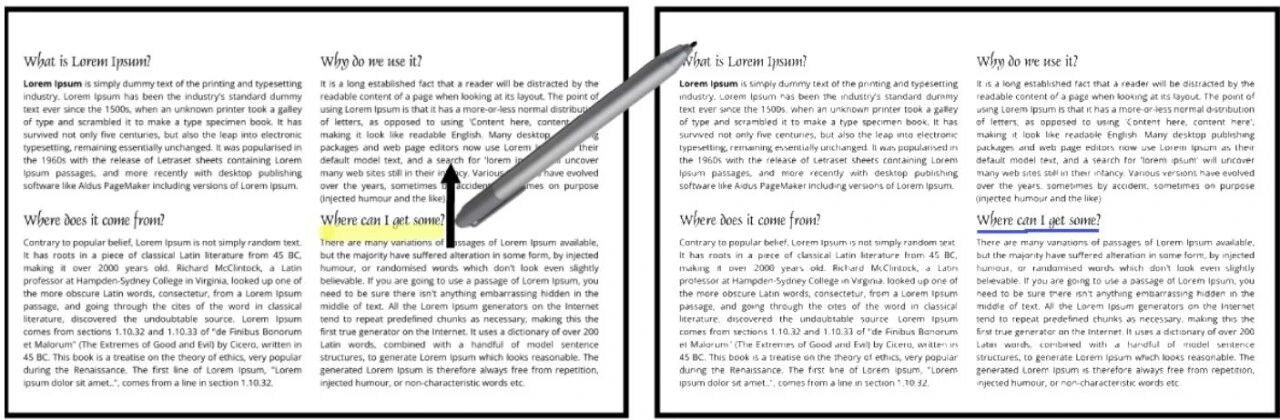
数字笔已经普及了很多年,但有一个问题几乎没怎么变过:模式切换。
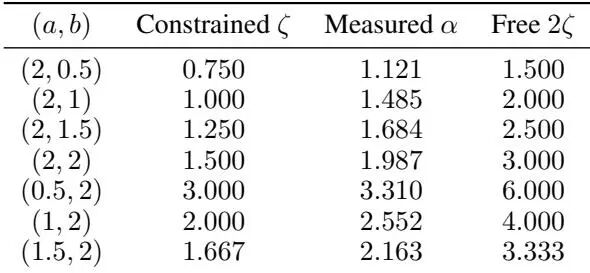
这篇论文回答的是缩放定律里最朴素也最要命的一个问题:多加一层,为什么有用?作者的答案有点反常识——在线性注意力里,深度只能按数据谱的幂律慢慢挤性能,很快就见底;注意力一旦带上 softmax 非线性,损失就按约 1/L 的逆幂律继续往下掉。作者还把这件事接到中心极限定理上,把「层间共享误差」和「层间差异」分开算账。
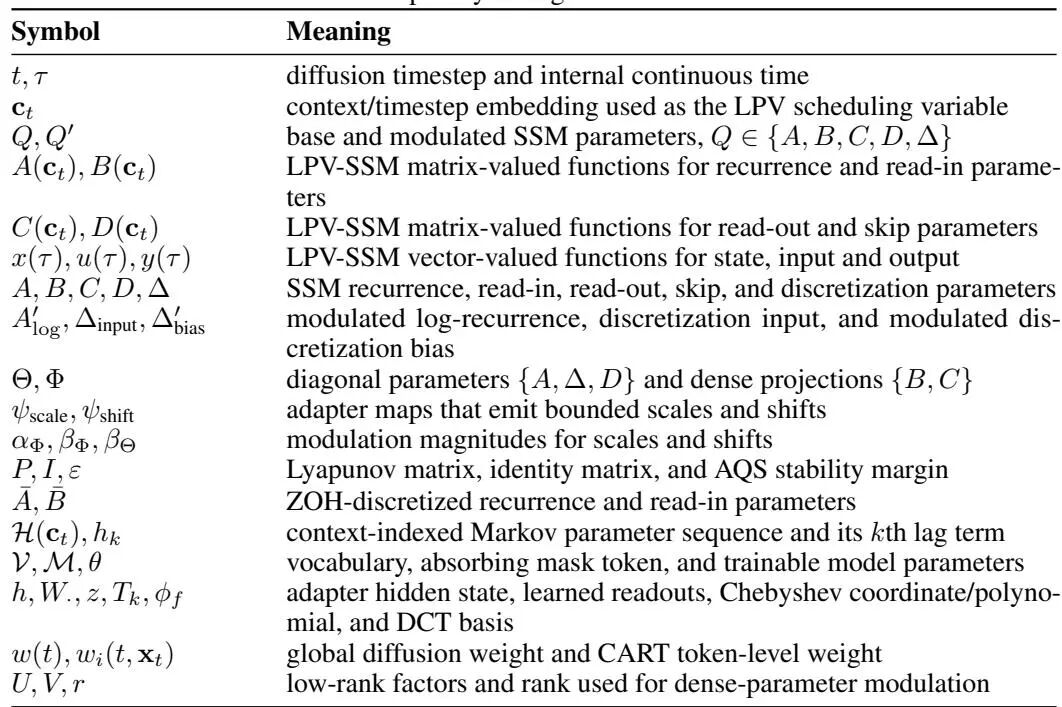
条件化这件事,主流做法要么把上下文塞进输入,要么用AdaLN去调激活,本质都是在外围打补丁。香港城市大学和英伟达AI技术中心这篇,直接把扩散时间步映射成SSM递归参数A、B、C、D、Δ的有界偏移,冻结111M骨干只训6.3到11M适配器,Chebyshev核平均验证损失压到2.55,还附送一份解析稳定性证书。能把"为什么稳"讲清楚的参数高效微调,不太多见,值
LONGGE AI COMMUNITY
加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。
加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。
 微信扫码加入知识星球