全球最大超声原始通道数据集:斯坦福×英伟达等38家机构开源40TB
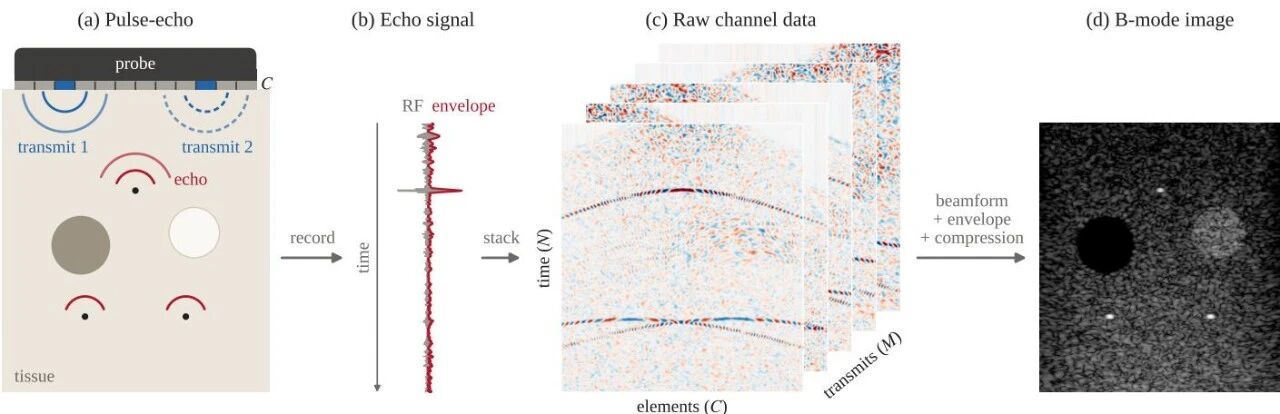
超声原始通道数据一直是块硬骨头:临床机器不给导,各家格式各说各话,一次采集动辄几个G。这篇把38家机构的约40TB数据拧成一个统一格式的开放语料,19,332次采集、覆盖从波束形成到血流成像再到智能诊断的十几类任务,算是给超声基础模型铺了块实打实的地基。
LONGGE AI RESEARCH DAILY
每天筛选值得关注的 AI 论文,用工程视角拆解方法、实验和真正的落地价值。
目前已发表 1811 篇文章
超声原始通道数据一直是块硬骨头:临床机器不给导,各家格式各说各话,一次采集动辄几个G。这篇把38家机构的约40TB数据拧成一个统一格式的开放语料,19,332次采集、覆盖从波束形成到血流成像再到智能诊断的十几类任务,算是给超声基础模型铺了块实打实的地基。
论文方法: 统一恢复框架(All-in-One)中的层级同质性与异质性建模框架(UniH3) 原文标题: UniH³: Unifying Hierarchical Homogeneity and Heterogeneity for All-in-One Medical Image Restoration 首次公开: 2026年9月10日(arXiv v1)

每次看到给医学图像分割加文本引导的工作,龙哥都会问一句:那行文字到底起多大作用?这篇论文用5个预训练医学视觉语言模型和4种融合算子做了系统性交叉实验,还提出一个轻量诊断工具做证据解耦,把“换融合头不涨点、去文本却崩盘”这类反直觉现象掰开揉碎了讲清楚,值得做多模态医学影像的读者花几分钟细读。

低剂量CT(LDCT)的临床价值不用多说——辐射剂量降低了,患者风险下来了,可图像里的噪声就上去了。泊松-高斯混合噪声趴在投影数据里,重建出来的图像出现条纹和伪影,直接影响医生下诊断。传统去噪方法靠人工先验,效果有限;

无线胶囊内镜拍出来的图常常模糊不清,而真实场景下几乎不可能拿到一一配对的清晰与模糊图对。这篇来自印度SVNIT与挪威NTNU的工作把Transformer放进无监督GAN里做四倍超分,还顺手提出了一个内镜专用的无参考画质指标,代码与预训练模型均已开源,值得做医学影像增强的读者仔细看看。

图像恢复越清晰,检测反而越容易翻车?SafeRestore告诉你:别急着让AI"修复"图像,先给修复结果发张"安全认证"再放行。这篇论文最精彩的地方,是诚实地展示了自适应策略如何在五次实验中只通过一次认证——比简单插值还没牌面。

标注数据稀缺是医学影像落地的头号绊脚石。SAUF-Net把视野从“预测结果的一致性”拉到“内部特征表示是否可靠”,用“结构-外观解耦”的思路直接回应伪标签误差累积这个老大难问题,在5%标注率下打出了超越不少10%标注方法的效果,值得所有做半监督分割的读者花几分钟看看。

扩散模型做超分,画质确实顶,训练也确实是出了名的“百万步起步”。这篇文章没动网络结构,只在训练目标里加一个冻结VGG的感知正则项,就能让脑MRI和彩色人脸超分稳定加速收敛,局部细节还更真。想低成本给扩散训练“加外挂”的读者,值得花三分钟读完。

要说清楚这篇论文在解决什么问题,得先从一张血管造影图说起。

一堆AI医生会诊,居然还会“抱团跑偏”?把肺癌晚期患者往肿瘤科一推,完全无视血氧已经掉到危险线。华南理工等机构最近祭出新框架MASGR,把松散群聊升级成结构化推理图,再请来“仲裁官”把关,转诊准确率一口气顶到95.3%。

医学图像分割被昂贵标注卡脖子多年,GazeRefine却用医生眼动当提示,在不需要任何训练的前提下把息肉分割做到88.10% Dice,一脚踩到全监督nnU-Net脚后跟。想让AI指哪打哪还不炼丹?这篇值得一读。零样本、免训练、免标注,核心思路极清爽:眼动点一下,冻结特征自动“长出”掩码。适合所有关心医学图像落地成本与交互分割效率的读者。

这可能是影像AI圈最该细品的一类研究:不看Dice涨了多少,而是问Dice涨了之后,医生做决策到底变没变。荷兰团队用10例增强CT、4位专家、1个nnU-Net模型,外加一套概率模拟,把分割边界差异直接翻译成临床评分差异。结论相当反直觉——几何差异不小,但rPCI总分平均波动不到1分,决策翻转全挤在PCI 20这个生死线附近。不卷精度的论文,反而把精度指标的
LONGGE AI COMMUNITY
加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。
加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。
 微信扫码加入知识星球