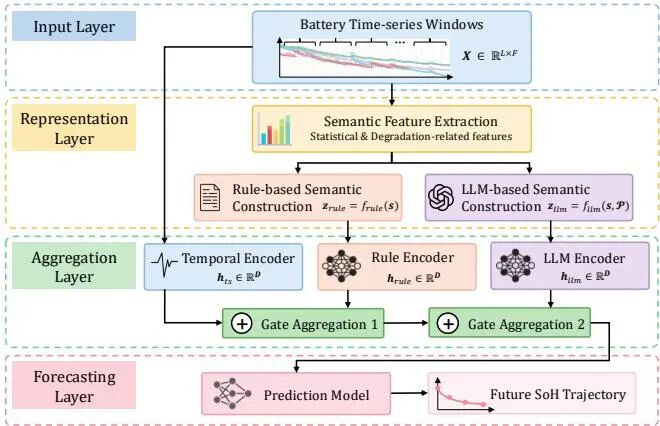
新加坡理工大学:电池健康预测加语义双引擎,误差最高降37.3%
电动车车主最怕的一件事,不是充电排队,而是电池"悄悄地"不行了。手机用两年续航肉眼可见地缩水,电动车开五年续航打折,储能电站跑几年之后调度策略得跟着改,这些现象背后都指向同一个量:电池健康状态(State of Heal。
LONGGE AI RESEARCH DAILY
每天筛选值得关注的 AI 论文,用工程视角拆解方法、实验和真正的落地价值。
目前已发表 1811 篇文章
电动车车主最怕的一件事,不是充电排队,而是电池"悄悄地"不行了。手机用两年续航肉眼可见地缩水,电动车开五年续航打折,储能电站跑几年之后调度策略得跟着改,这些现象背后都指向同一个量:电池健康状态(State of Heal。
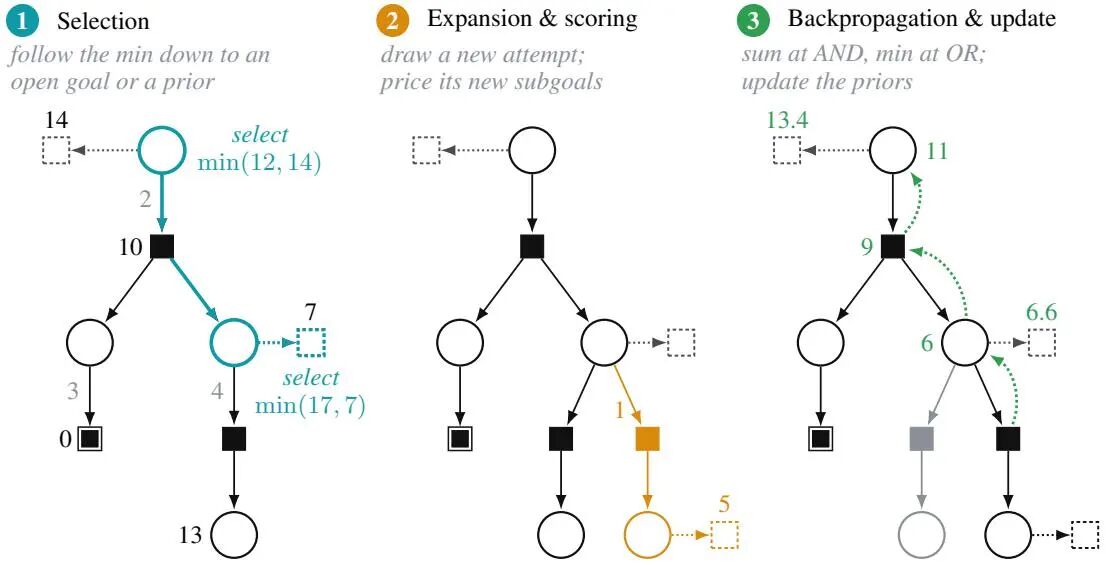
证明这东西,对只是及格线。数学家还挑它短不短、纯不纯、找起来贵不贵。哥伦比亚大学这篇LEVER,把这几件事直接写进搜索目标,成本降了三成多,解出率反而从80%升到96.3%。
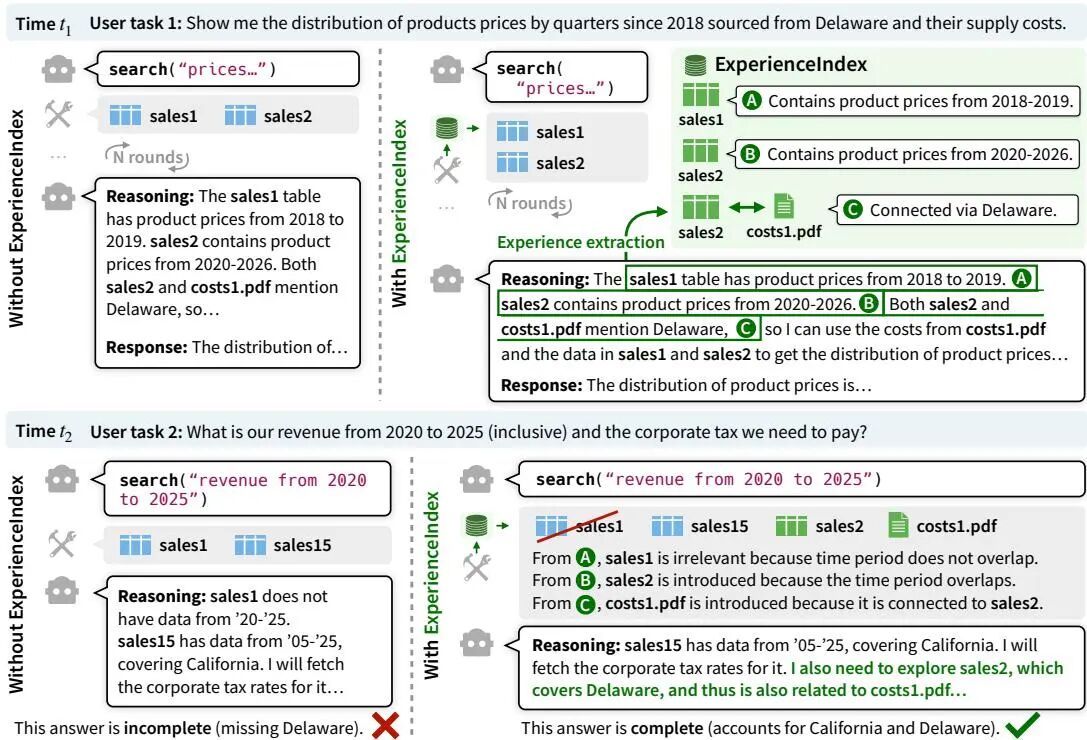
想象一个干了十年的财务顾问,面对杂乱报表,他翻完一遍后脑中会留下便签:“这张表够用”,“那份文件跳过”。下次再来任务,他按便签取该看的东西,既快又准。
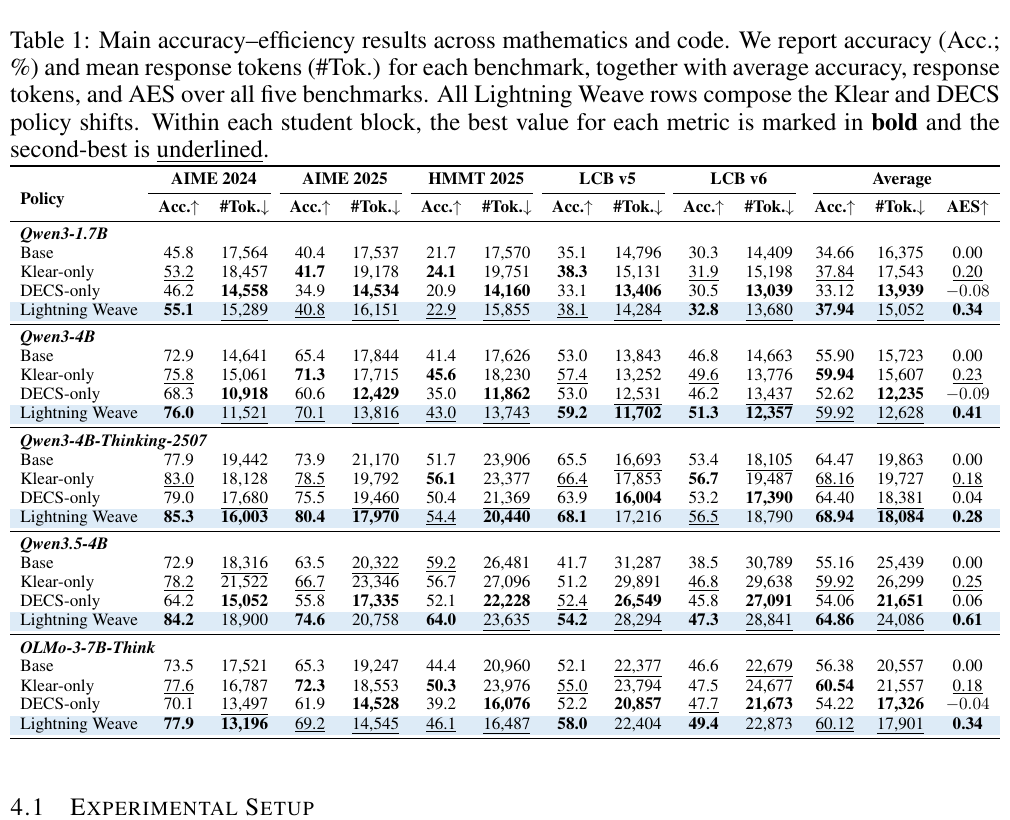
论文基本信息 原文标题: Lightning Weave: Improving the Accuracy-Efficiency Frontier of Reasoning Models through Capability Composition 首次公开: 2026年9月14日(按 arXiv 首次公开时间换算为北京时间) 署名单位: 麻省理工学院、英伟达
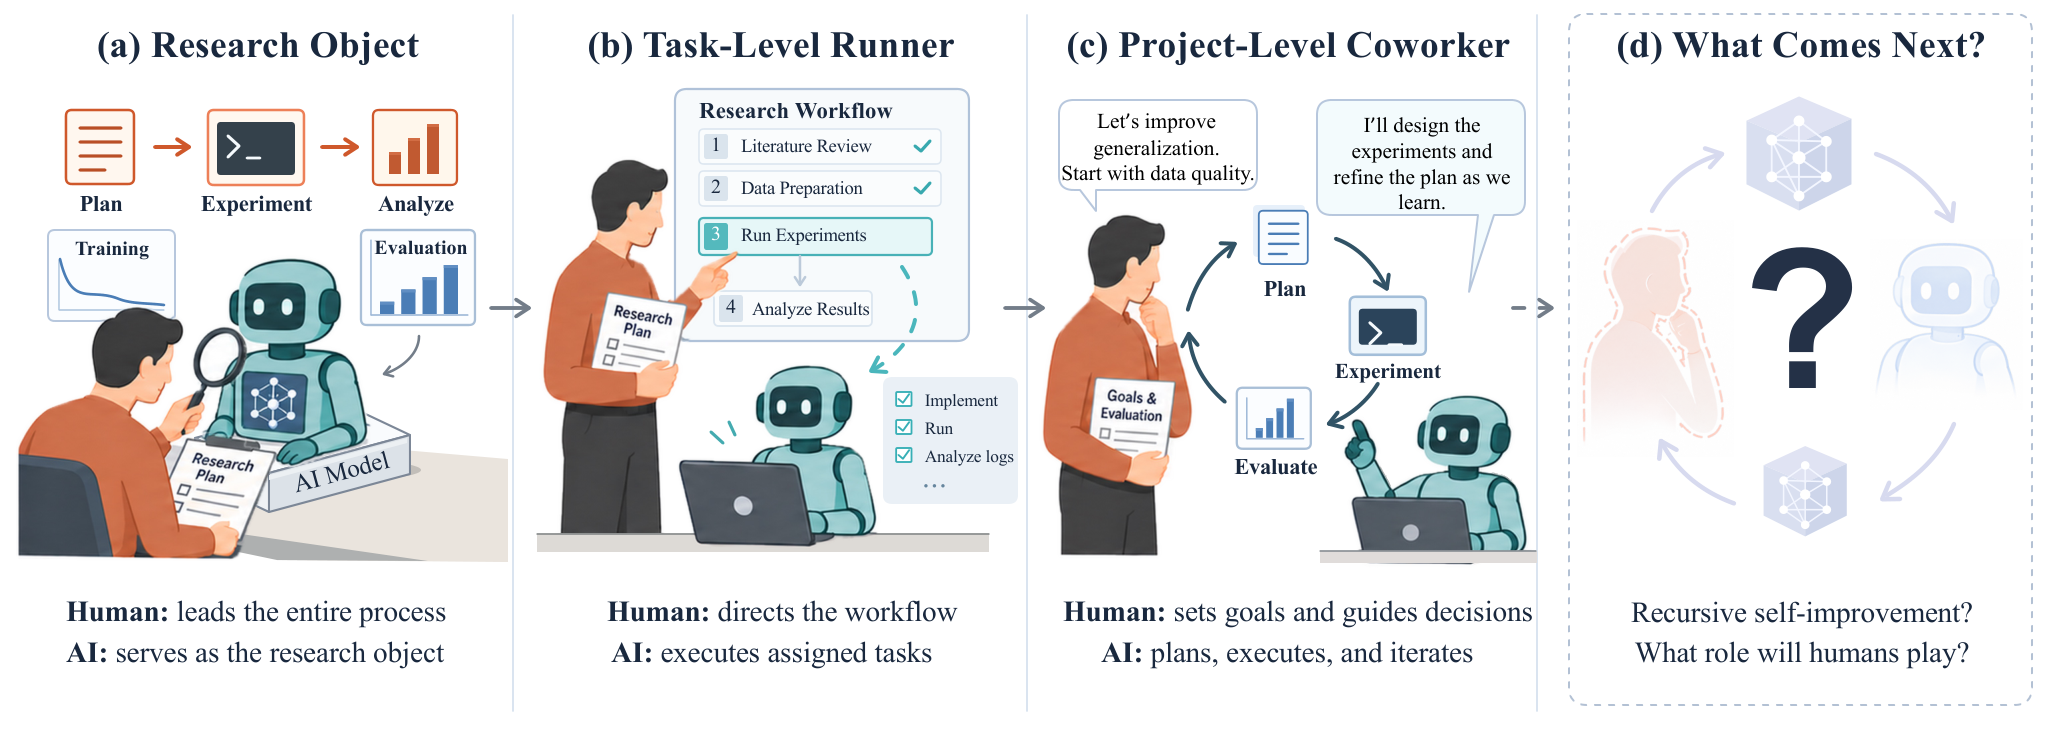
论文基本信息 模型名称: Atria Dawn Preview 原文标题: Atria Dawn: The Dawn of Agentic Superintelligence — On the Evolving Roles of Human–AI Collaboration 署名单位: 上海人工智能实验室、复旦大学 首次公开: 2026年9月14日(arXi
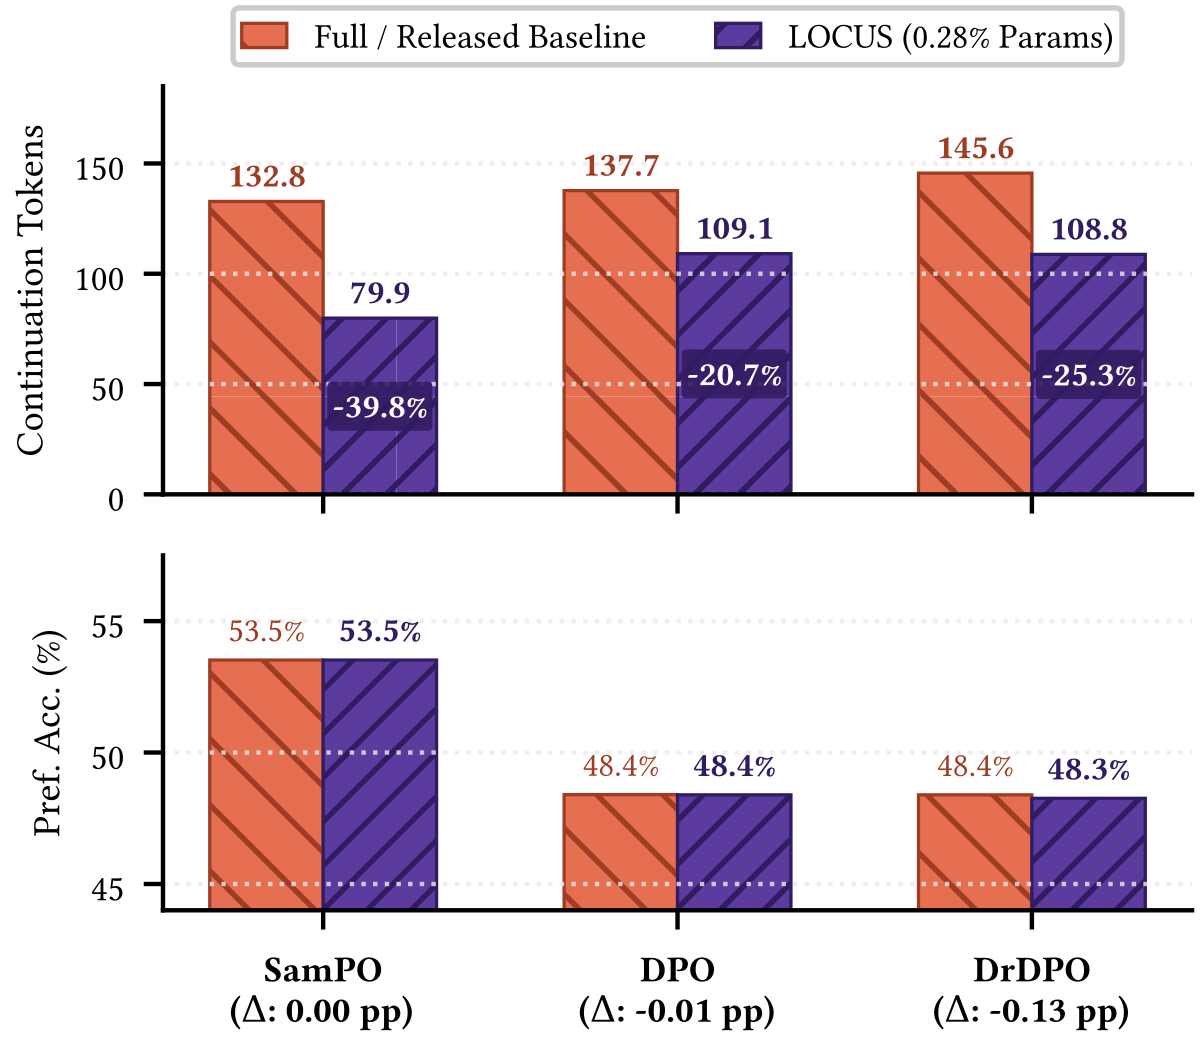
论文方法: 长度优化低秩后训练方法(LOCUS) 原文标题: LOCUS: Task-Aware Low-Rank Post-Training for Token-Efficient Language Generation 第一署名单位: 华盛顿大学 具体领域: 大模型偏好后训练 首次公开: 2026年9月10日(arXiv v1) 原论文: htt

还在让代码大模型硬啃题目?上海交大等机构提出的TIPCODER做了个示范:先别急着写代码,让模型根据具体问题"出个主意",再动笔。就这么一个前置小动作,一次生成的效果反超了Best-of-8的多次采样,平均通过率最高冲到71.10,有点东西。

考过程序设计竞赛的读者应该都有同感:决定命运的不是“你觉得自己写对了”,而是评测数据有没有精准戳中你代码里藏得最深的bug。

如果把短视频推荐系统想象成一家大型仓库,算法的工作就是“在仓库里找一件用户最可能喜欢的东西”。仓库越大,推荐越准。可问题在于:算法再聪明,也只能在仓库里挑,不能在用户最想要的那一刻,照着用户的心思现场做一件出来。

LLM做5G故障根因分析,最怕的就是一本正经地编证据。三星美研这次把“证据→诊断路径→结论”结构化地塞进微调过程,让1.5B小模型直接干出94.2%准确率。想研究LLM垂直落地与“反幻觉”设计的同学,这篇值得细读。

写代码时如果发现bug,你会不会把错误日志贴到代码最前面,一边看一边改?清华与Z.ai这篇新作就是干这个的:让大模型先自己想一遍,把推理草稿提到长正文前面再来一次,GraphWalks上准确率直接从29.2%飙到81.8%!

大模型生成视频"看起来美,动起来假"的顽疾有解了。这篇来自四川大学的工作,不去堆算力,而是给视频生成装上"物理事件链"大脑,用可量化的物理公式约束每个中间状态,在PhyGenBench上把物理贴合度均值提升到72.5%,值得做视频生成与世界模型的朋友细读。
LONGGE AI COMMUNITY
加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。
加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。
 微信扫码加入知识星球