罗格斯大学:非正则Borel图色数下界,Nikiforov定理被推广
无限图的着色问题一直有个尴尬:经典谱方法大多只在“人人度数相同”的正则图上顺手。这篇把 Nikiforov 的色数下界、二部性谱刻画一路搬到非正则的 Borel pmp 图,还顺手用可测支配数卡住了 Laplacian 谱隙。纯理论,没有一行代码,但证明思路干净得值得一看。
LONGGE AI RESEARCH DAILY
每天筛选值得关注的 AI 论文,用工程视角拆解方法、实验和真正的落地价值。
目前已发表 1811 篇文章
无限图的着色问题一直有个尴尬:经典谱方法大多只在“人人度数相同”的正则图上顺手。这篇把 Nikiforov 的色数下界、二部性谱刻画一路搬到非正则的 Borel pmp 图,还顺手用可测支配数卡住了 Laplacian 谱隙。纯理论,没有一行代码,但证明思路干净得值得一看。
一个可视化平台宣称自己算出来的数字和手写脚本一样,这话到底该不该信?Nimbus BCI 给出的答案是:六条经典脑电解码流水线,三个公开数据集,两种评估协议,平台引擎与独立手写实现各跑一遍,逐被试比准确率。确定性流水线全部 0.00 点一致,深度模型的差异落在训练种子噪声里。软件平台自己做验证研究,这事本身就少见,值得看一眼它的验证设计和边界。
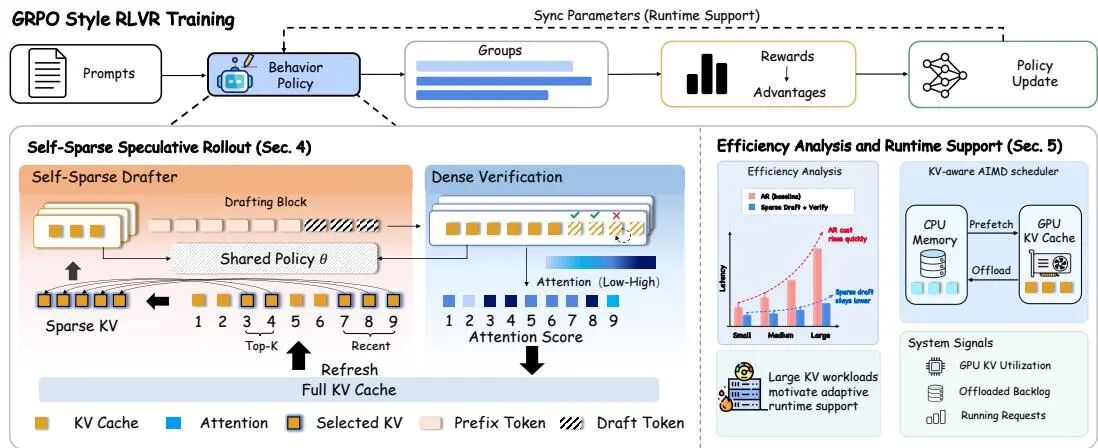
大模型做强化学习,真正的瓶颈常常不在反向传播,而在 rollout 生成——注意力吃掉了七成以上的解码时间。港科大(广州)这篇 S3R 的做法挺取巧:稀疏注意力只负责"提词",全注意力负责严格验收,采样分布不动,KV 读取却大幅减少。Qwen3-1.7B 上端到端训练吞吐做到 1.39 倍,训练还更稳。
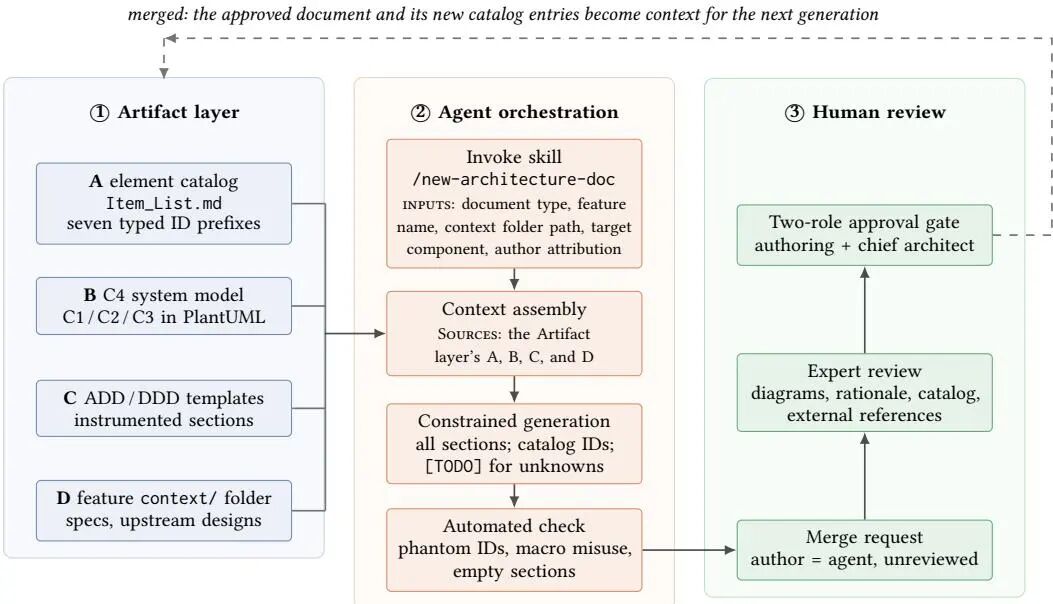
这个不对称其实很好解释。代码能编译就是能编译,编译不过就是过不去,对错有硬反馈,智能体可以在里面反复试错。
AI 这次不写代码,改去啃数学硬骨头:中心荷 c=8、实现 Haagerup 双重 Z(ℋ₃) 的顶点算子代数被显式构造出来。更值得看的是过程账本——Astra 6 找了 3 小时 22 分,Sol 6.1 想了 1 小时 6 分给出证明。结论仍待社区复核,但这份 AI 参与数学发现的一手记录,本身就稀有。
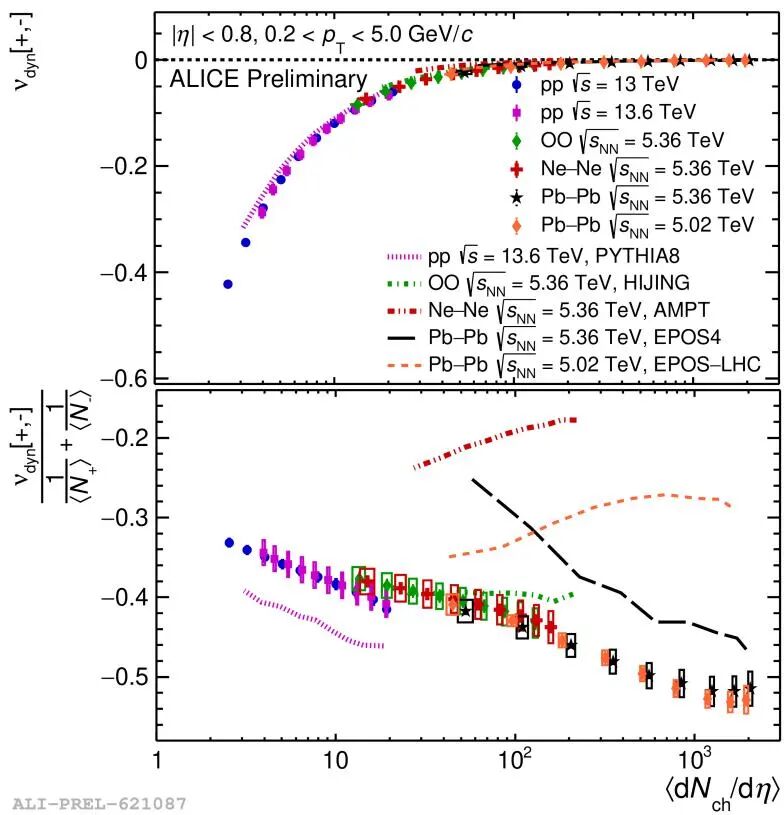
先把场景搭起来。CERN 的大型强子对撞机(Large Hadron Collider,LHC,欧洲核子研究中心运行的大型强子对撞机)把铅原子核加速到接近光速,然后让它们迎头撞上。
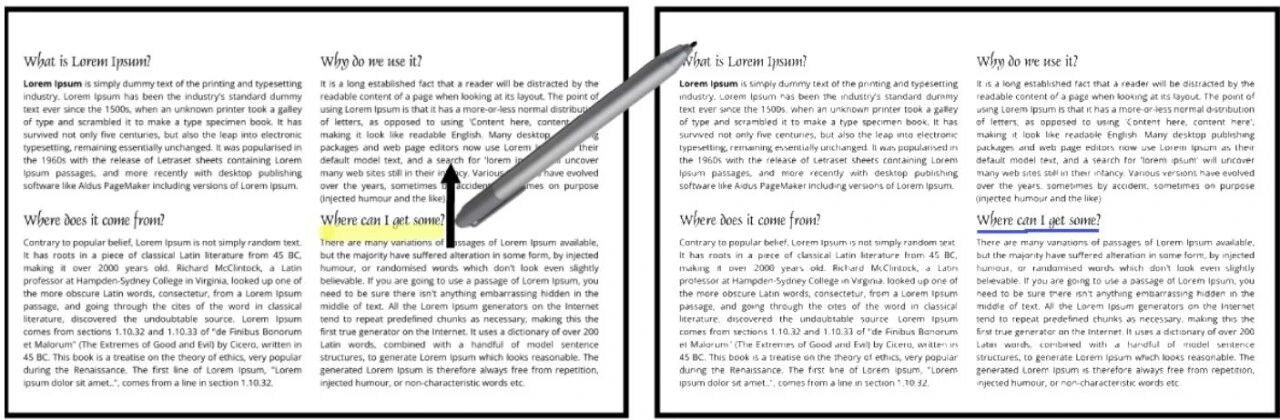
数字笔已经普及了很多年,但有一个问题几乎没怎么变过:模式切换。
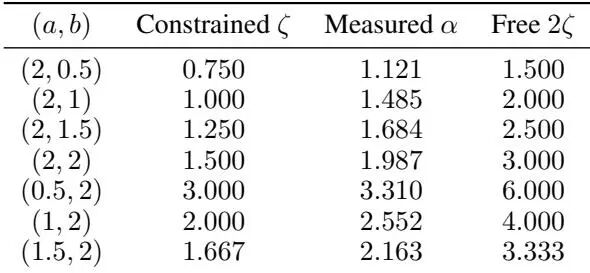
这篇论文回答的是缩放定律里最朴素也最要命的一个问题:多加一层,为什么有用?作者的答案有点反常识——在线性注意力里,深度只能按数据谱的幂律慢慢挤性能,很快就见底;注意力一旦带上 softmax 非线性,损失就按约 1/L 的逆幂律继续往下掉。作者还把这件事接到中心极限定理上,把「层间共享误差」和「层间差异」分开算账。
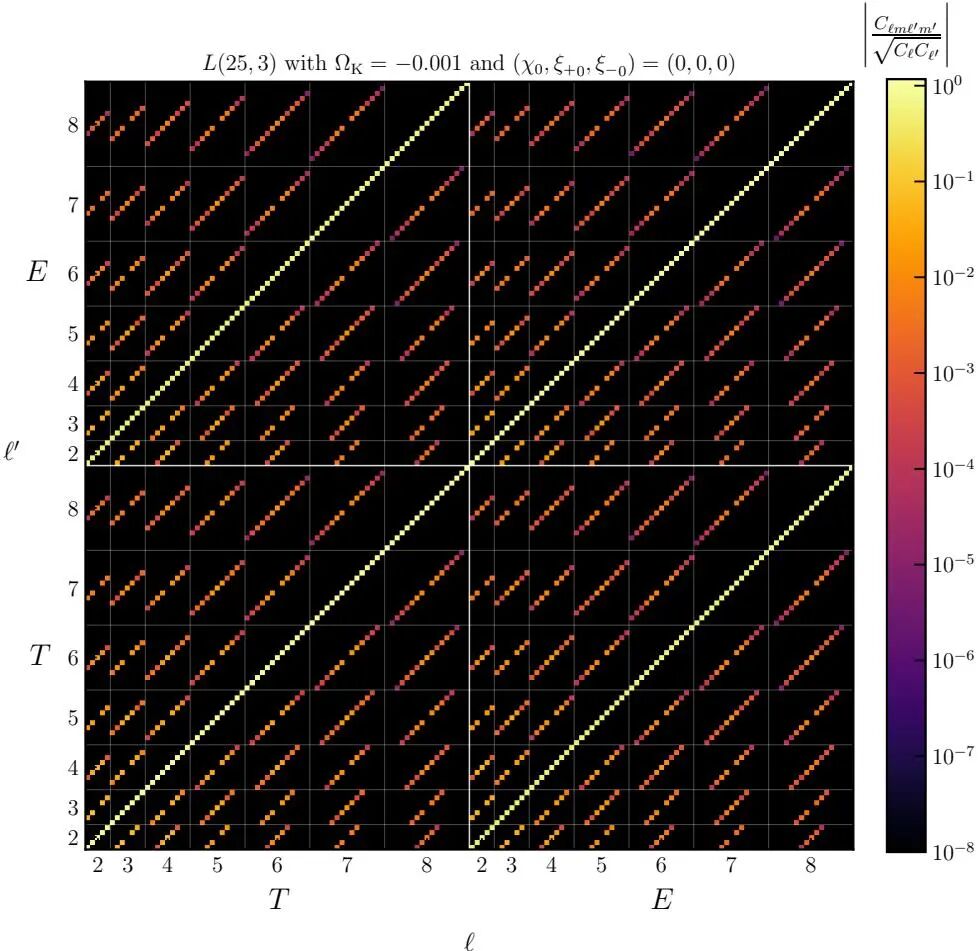
宇宙有没有「重复的走廊」?这篇 COMPACT 合作组的新论文,第一次把任意透镜空间的 CMB 全谐空间协方差矩阵算了出来,包括长期被忽略的非对角项。结论有点反常识:哪怕天上找不到配对圆,拓扑信号仍可能藏在统计结构里,而且能多撑 10%。
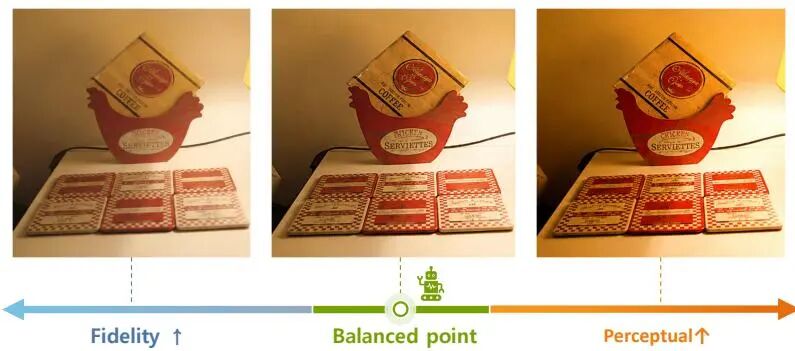
调损失权重这件事,以往基本靠炼丹手感和几轮消融碰运气。这篇论文干脆把LLM塞进训练循环:每隔一段拿固定小样本跑一遍质量指标,让它的下一段训练自己决定该更看重保真,还是更好看。改的全是现成损失项,网络结构、优化器、数据管线、推理流程一个没动,训练额外开销不到0.2%,推理零成本。三个恢复任务、七个基准,都挪到了更划算的平衡点上。🤨
先从一个看起来特别朴素的问题开始:往一个带电荷 Z 的原子核旁边塞电子,它最多能"抱住"几个?这里的动词很关键,是"抱住",不是"塞进去"。电子之间互相排斥,塞得越多,最外面那层的电子越容易掉头就跑。
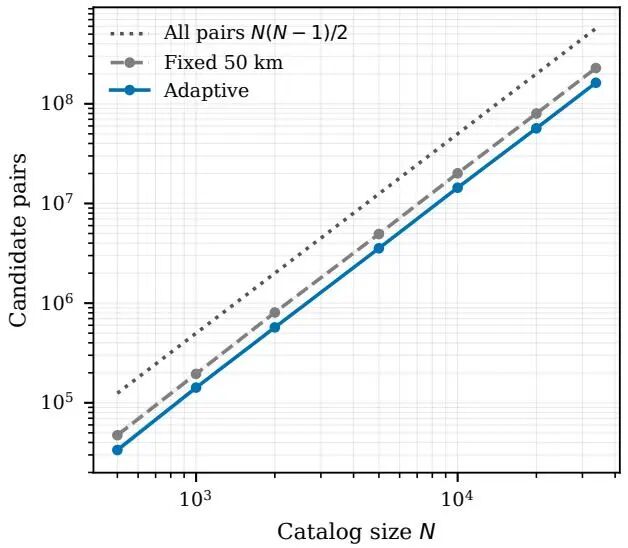
太空越来越挤,几万颗卫星的轨道交会筛选正在变成算力灾难。斯坦福这篇论文不换模型、不堆显卡,只用公开星历历史给每个目标单独估一个不确定度,把固定50公里阈值改成自适应阈值,候选对直接砍掉近三成,扫描速度还快27倍。在算力普遍吃紧的当下,用一次漂亮的"减法"换回大笔计算预算,这种思路值得每个做大规模筛选的人读一读。
LONGGE AI COMMUNITY
加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。
加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。
 微信扫码加入知识星球