
科罗拉多大学安舒茨医学中心:1.1万例右上腹多帧超声,打通识别、报告与手术分诊
论文基本信息 原文标题: A multitask framework for automated multi-frame right upper quadrant ultrasound interpretation and clinical decision support 期刊与日期: Nature Communications,2026 年 9 月 7
LONGGE AI RESEARCH DAILY
每天筛选值得关注的 AI 论文,用工程视角拆解方法、实验和真正的落地价值。
目前已发表 1811 篇文章
论文基本信息 原文标题: A multitask framework for automated multi-frame right upper quadrant ultrasound interpretation and clinical decision support 期刊与日期: Nature Communications,2026 年 9 月 7
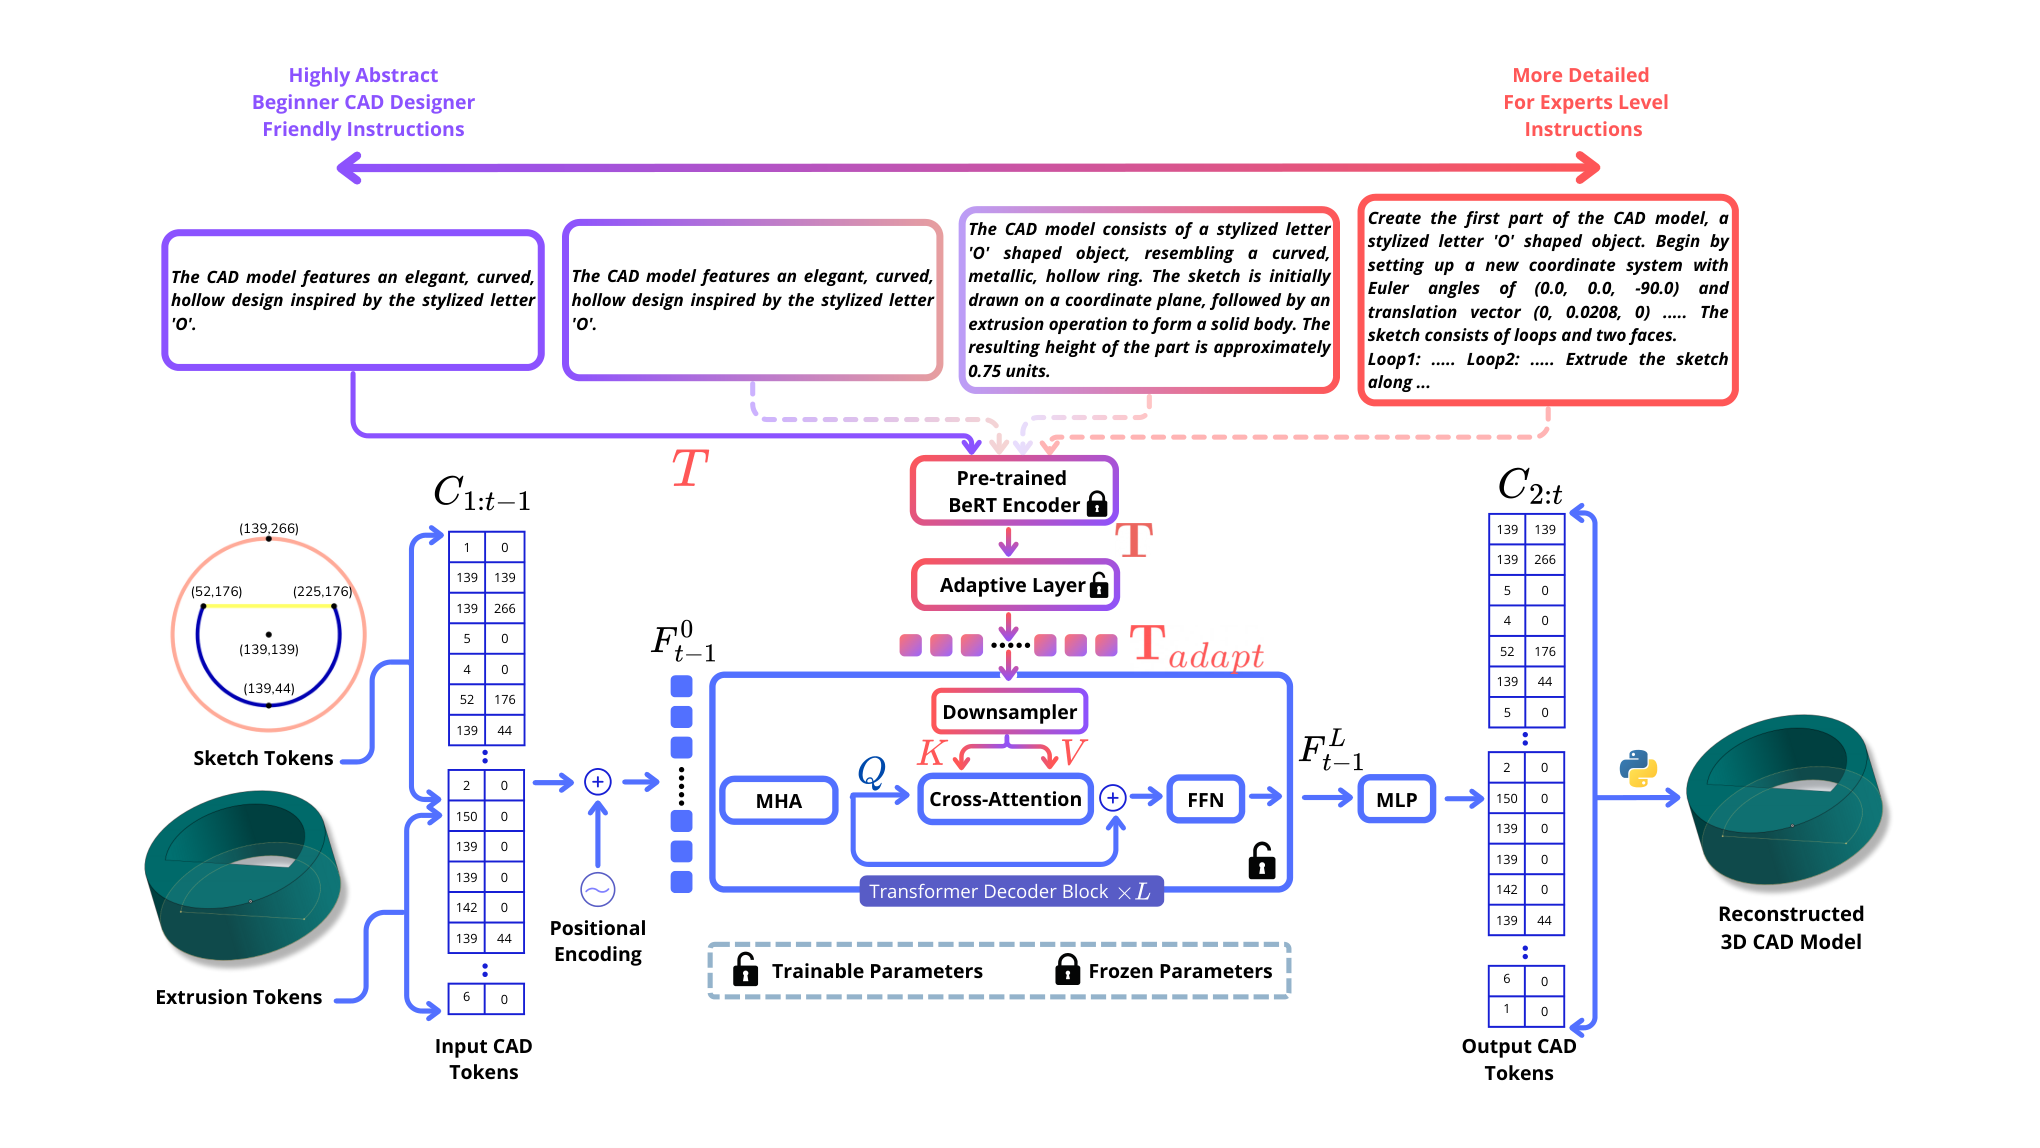
过去两天,两篇面向真实工业设计的新论文把CAD生成推到同一个问题前:AI输出一段能运行的建模代码,究竟算不算完成了设计?答案越来越明确——能执行只是起点,零件要像、尺寸关系要合理、装配要成立,还要保留后续编辑空间。本文精选7篇代表作,梳理这条从命令序列到工业装配的完整技术链。
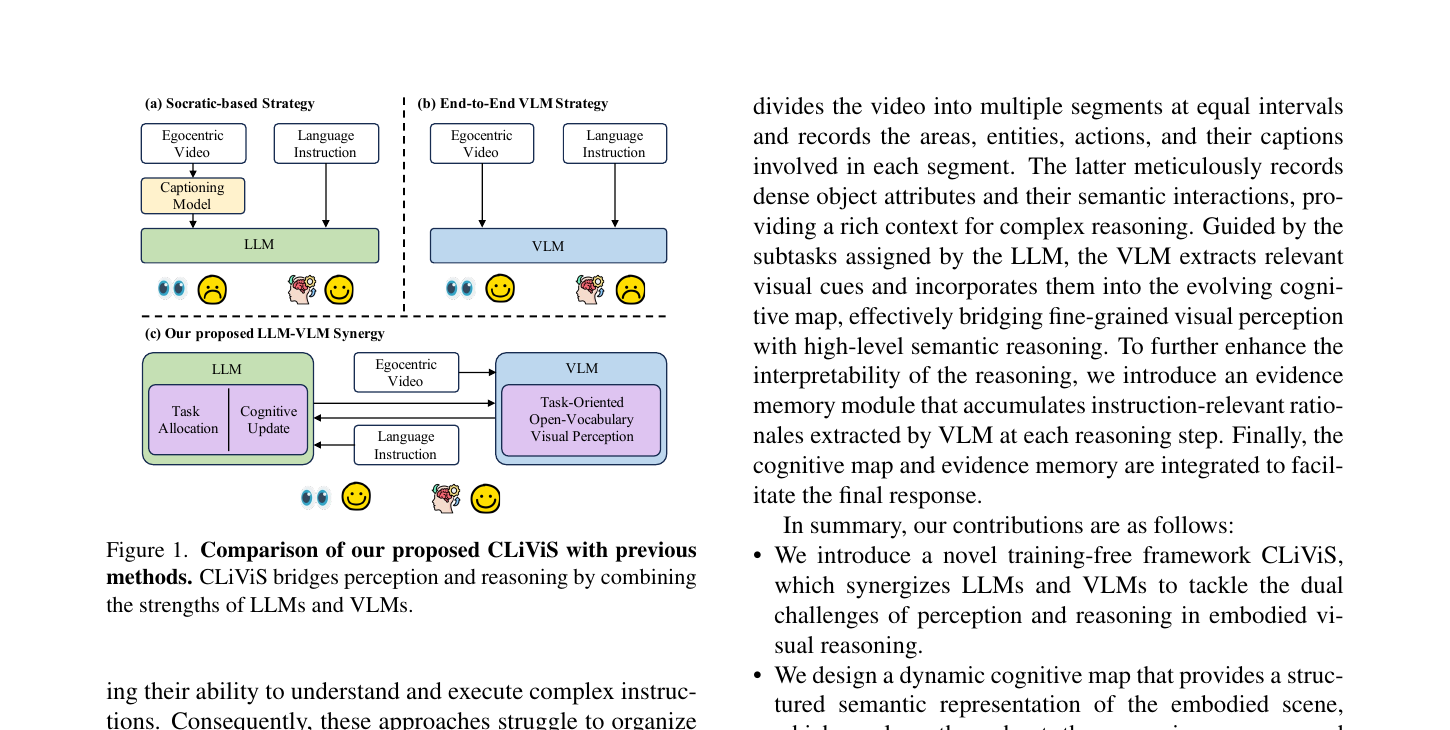
论文基本信息 原文标题: CLiViS: Unleashing Cognitive Map through Linguistic-Visual Synergy for Embodied Visual Reasoning 作者单位: 华东师范大学、阿卜杜拉国王科技大学、复旦大学 首次公开: 2025年6月21日(arXiv v1) 正式发表: CVPR 202

传统印象里,CAD建模是工程师坐在电脑前,对着软件菜单点点拖拖,从草图拉伸、切除、倒角一路做到出工程图。

如果把短视频推荐系统想象成一家大型仓库,算法的工作就是“在仓库里找一件用户最可能喜欢的东西”。仓库越大,推荐越准。可问题在于:算法再聪明,也只能在仓库里挑,不能在用户最想要的那一刻,照着用户的心思现场做一件出来。

先来看一种并不罕见的场景:在产品包装设计、店铺招牌生成、设备铭牌渲染这类视觉内容创作任务里,用户往往给模型下达一个明确指令——在某个指定的主体区域(比如一家面包店的招牌、一辆货车的车身、一瓶饮料的标签)写入指定的文字,同。

让AI画“时间就是金钱”,它可能真画一个挂满钞票的时钟;让AI画“知识就是力量”,它又可能把书本和哑铃硬拼在一起。文生图模型能把物体画得很真,却常常画不出“画外之音”。同济大学等机构提出VMetaphor-Bench,把“视觉隐喻生成”这件事第一次系统性地量化评测,结果连GPT Image 1.5也栽在结构组合上。

大型视觉语言模型(LVLMs)的视觉幻觉问题,本质上是个“看图说话翻车现场”——模型明明没看见那个物体,却说得言之凿凿。

让AI准确渲染又长又密的文字,是图像生成的“最后一公里”。复旦携手小红书放出一招“位置锚定”新设计,把文字准确率直接拉高一大截,海报再密也不怕了。

当所有文生图评测还在卷画质和指令跟随,UIUC这次直接把“答案藏在图里”的推理题丢给模型。2000道题、9个主流生成模型,最强Gemini 3 Pro也只拿64.6分。想看生成模型到底有多少“真推理”,这片试金石值得收藏。

大模型生成视频"看起来美,动起来假"的顽疾有解了。这篇来自四川大学的工作,不去堆算力,而是给视频生成装上"物理事件链"大脑,用可量化的物理公式约束每个中间状态,在PhyGenBench上把物理贴合度均值提升到72.5%,值得做视频生成与世界模型的朋友细读。

每次看到给医学图像分割加文本引导的工作,龙哥都会问一句:那行文字到底起多大作用?这篇论文用5个预训练医学视觉语言模型和4种融合算子做了系统性交叉实验,还提出一个轻量诊断工具做证据解耦,把“换融合头不涨点、去文本却崩盘”这类反直觉现象掰开揉碎了讲清楚,值得做多模态医学影像的读者花几分钟细读。
LONGGE AI COMMUNITY
加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。
加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。
 微信扫码加入知识星球