
图像恢复|天津大学ZVRM:零样本视频修复提速近3倍,时序闪烁减八成
又一篇零样本视频修复的狠活。天津大学团队把文本到图像扩散模型用出了花:不用训练就能修视频,还支持文本、图像两种参考输入,推理速度直接砍到三分之一,时序一致性指标WE降到原来的五分之一。被视频闪烁折磨过的同学,这篇值得重点研究。
LONGGE AI RESEARCH DAILY
每天筛选值得关注的 AI 论文,用工程视角拆解方法、实验和真正的落地价值。
目前已发表 1811 篇文章
又一篇零样本视频修复的狠活。天津大学团队把文本到图像扩散模型用出了花:不用训练就能修视频,还支持文本、图像两种参考输入,推理速度直接砍到三分之一,时序一致性指标WE降到原来的五分之一。被视频闪烁折磨过的同学,这篇值得重点研究。
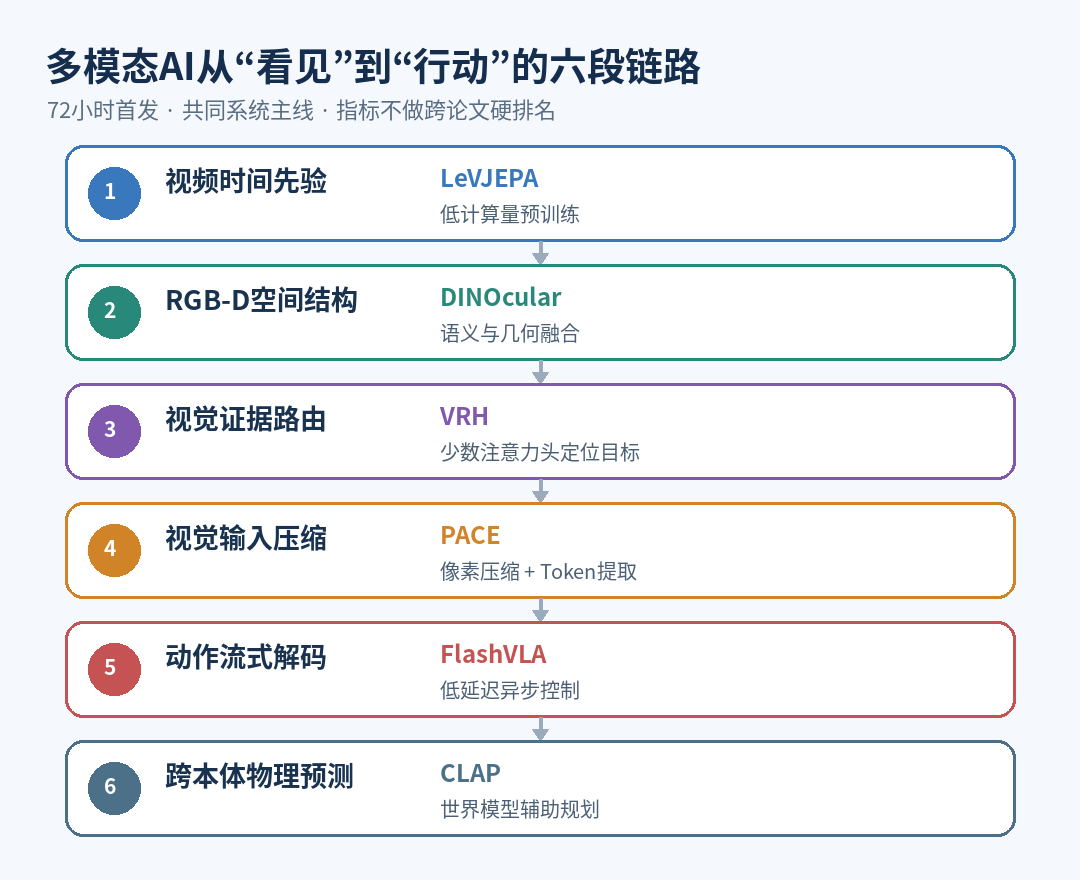
一套多模态系统可以在图片问答里拿高分,却未必能在真实机器人上及时完成一次抓取。问题不只出在模型是否“聪明”,而是视频表征、空间几何、证据路由、视觉压缩、动作生成和物理预测能否在同一时间预算里闭环。 过去72小时首发的6篇论文,恰好把这条链路的六个关键瓶颈同时摊开。

3D高斯泼溅遇上开放词汇理解,过去大家往点云里硬塞特征,结果存储爆表、边界糊成一片。北大这篇CVPR 2026新作反其道而行,把几何和语义彻底解耦,用VLM生成文本假设做外置索引,直接让特征存储从GB级砍到MB级。思路清奇,落地极香,值得一读!

这篇来自Apple的新研究直接把“视觉思维”做进了训练:模型在训练时预测未来帧的潜在表示,推理时不再生成中间图像,端到端延迟比显式视觉CoT降低5倍以上,同时在6个评测设置上稳定超越纯文本后训练。对视频理解、实时预测和统一多模态模型感兴趣的同学值得细读。

图表理解长期卡在数据上:规模小、模态不全、代码缺失。MIT、IBM联合开源ChartNet,150万张图表、24种类型、6种绘图库,五种模态完全对齐,居然让2B小模型在图表重建、数据提取上超越GPT-4o,这数据质量有点东西。
多模态RAG最让人头疼的不是"找不到证据",而是"证据太多太吵"。东南大学这篇GraphLoom把Llama-3.1-8B冻住,只训练160万参数,用可靠性校准的证据路由在三大多模态问答基准上全面超强基线,还把幻觉率压到10.5%。

24小时动态心电(Holter)是诊断心律失常的金标准,但多模态大模型在超长时序信号面前几乎“失灵”。浙大等团队开源Holtercare-Bench基准与Holtercare-23K数据集,用信号-视频-文本三模态对齐,让GPT-5、Qwen3-VL等模型首次系统性接受“心电马拉松”考验——微调后时序定位准确率飙到99.7%,差距比想象中更大。

康奈尔大学CVPR 2026新作,用电影解说视频自动构建8231个问答对,提出无参考评估新范式。结果发现GPT-4o、Claude 3.5等顶级模型看电影,视觉几乎帮不上忙,纯靠字幕反而分更高,值得所有做多模态的人细品。

4K分辨率下改图,既要改得准、还要改得快、更要纹理细节不丢失,这可能吗?阿里千问与上海交大给出的答案是:61秒,一个细节都不少。

如果让一个从来没出过村的老学究,突然面对整个互联网的图片,他会怎么看世界?大概率是懵的。反过来,如果把全世界最聪明的AI模型扔进一座百年图书馆,让它只看一堆发黄的书页扫描件,它也会懵。

你的AI助手能记住你三个月前说过"最近改喝零度可乐"这种小事吗?还能看出你最近压力大、回答时自动把语气调到安静模式?南京大学和字节跳动这篇CVPR 2026工作,把"长期记忆+动态人格对齐"做成了完整框架,在自建基准上把GPT-4o都赢了,值得一看。

多模态大模型“一本正经地胡说八道”是落地最大痛点之一。这篇CVPR 2026论文把幻觉拆成“感知偏差”和“推理漂移”两类,用不到1%的额外计算找到该加强的注意力头,平均提分4.2%且完全无需训练,插拔即用,值得所有做多模态推理的团队收藏。
LONGGE AI COMMUNITY
加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。
加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。
 微信扫码加入知识星球