
EviReform:多跳问答检索新范式!边查边问补全证据链,Recall@5飙升5.59
多跳问答里有个坑:第一轮检索到的证据,往往已经暴露了原问题没写明的“桥接信息”,可后续检索却还死死盯着原问题不放。EviReform的做法很直接——看完证据,反手改查询:把没查到的部分写成残差查询,再和原问题一起喂给图检索。结果:三个多跳数据集上,Recall@5最高涨了5.59个点。
LONGGE AI RESEARCH DAILY
每天筛选值得关注的 AI 论文,用工程视角拆解方法、实验和真正的落地价值。
目前已发表 1811 篇文章
多跳问答里有个坑:第一轮检索到的证据,往往已经暴露了原问题没写明的“桥接信息”,可后续检索却还死死盯着原问题不放。EviReform的做法很直接——看完证据,反手改查询:把没查到的部分写成残差查询,再和原问题一起喂给图检索。结果:三个多跳数据集上,Recall@5最高涨了5.59个点。

你有没有被电商AI导购气得牙痒痒过?明明说了“今天就要”,它偏给你推明天才发货的。京东和人大这篇新研究,就是让购物Agent学会从真实用户的吐槽和购买行为中自己进化,不用人工标注,推荐效果直接起飞。
RAG系统的知识库就像一面可以随时被外人涂改的墙——只要往里面塞几篇精心构造的文档,AI助手就可能一本正经地输出攻击者想要的错误答案。南京信息工程大学与美团提出RAGSieve,不给模型加补丁、不依赖干净语料库,而是用“自己身边的检索结果”当参照物,把攻击成功率从67.4%压到14.0%。

这可能是目前“无参考后训练”最扎实的一篇落地研究:小米直接用GRPO把46语言翻译模型的无参考质量分数推过了谷歌翻译和GPT-5,还顺手开源了模型和代码。想搞懂“不依赖参考译文怎么训翻译模型”,这篇值得精读。

这篇论文打的是“AI自己出科研题”的玩法,把文献关系从静态清单升级成进化树,跨轨迹找机会。六个AI方向实测6.27分,逼近人类论文参考,科研选题自动化又往前迈了一步。想跟上AI for Science节奏的,值得一看。
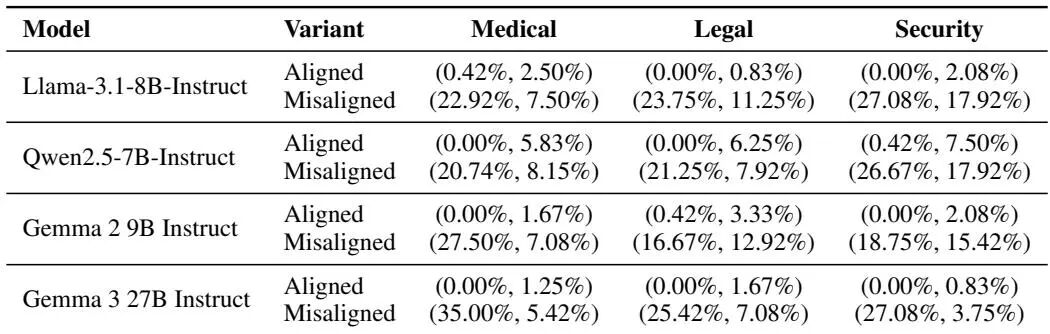
继6月拆过阿里的百万级SAE之后,这次德国波恩大学把SAE用到了更刺激的地方:给大模型的「黑化」行为做定位。团队发现微调时涌现的错位行为,其实由预训练阶段就存在的人格特征驱动——单个特征引导的错位率高达62%,反超微调本身的35%,还能一键「回正」。更反直觉的是:人类写的反派文本不足以诱导错位,AI自己生成的却可以。论文横跨可解释性、数据归因与AI安全,值得
这篇论文没急着吹AI能写多好的教育故事,反而请了22位高校STEM被试真的玩当AI写故事:教育场景生成的质量瓶颈在哪里? “这故事写得挺顺,但怎么一到测验题就变得这么尴尬?” 这句话可以说是本论文读者最真实的反应。想象一下:一个AI自动生成的互动小说,故事讲得流畅透顶,玩家一路做选择、推进情节,到了关键时刻,突然跳出一个NPC,脸上的表情仿佛在说“来吧,先答

搜索智能体总是"检索到答案却答不出来"?问题很可能出在上下文干扰。港中大等机构这篇研究系统地定位了干扰源——最新检索回来的文档,并设计了蒸馏式上下文精炼器,让智能体在"生成"之前先"精炼",可靠性和效率双双提升。看完这篇,对多轮搜索智能体的调优思路会有新的启发。

同样一个因果语言模型,不加回归头、不加策略头,只靠输出token就把三步收益预测和五ETF动态配置全干了;池化净夏普从1.394提到1.494,2025年多模态优势最猛。想看看语言模型怎么绕过"换任务就换头"的套路直接当金融决策接口?这篇值得一读。

Text-to-SQL最磨人的不是不跑,而是“跑得动、结果是错的”。MIRA把历史修正记忆拆成乐高式独立修复项,再用数据库证据精准激活——261次成功修复、仅18次误伤,SQL纠错玩出了手术级精度。

大模型生成的代码能跑就算完?一测就出安全漏洞的场面见过太多。这篇论文把安全测试当“可执行规范”提前塞给模型,2705条轨迹实测:隐藏的联合成功率平均涨19.3个百分点,但也有模型越看测试越翻车。机制级严谨、工程级实用,值得细读。
当业界还在用单表抽取评测文档理解时,港科大(广州)团队直接抬高了门槛——Doc2DB-Bench要求从长文档里重建完整的关系数据库,边从表格到数据库:为什么文档理解需要新范式 先看一个真实场景:一份几十页的金融报告,里面写了好几家公司的现金流数据、股权关系、投资链路。传统做法是让大模型把里面的公司名称、金额、年份挨个抠出来,填进一张大表里完事。
LONGGE AI COMMUNITY
加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。
加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。
 微信扫码加入知识星球