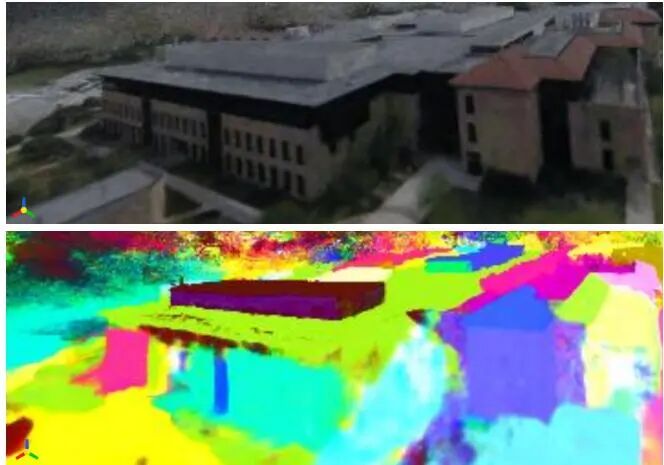
通用分割模型看不懂建筑?SAM 2.1微调后幕墙IoU涨35.5点
一栋楼站在那儿,几十米高,几千个构件。想把它搬进电脑,常见做法是让无人机绕着飞一圈拍上千张照片,再交给算法重建三维模型。

LONGGE AI RESEARCH DAILY
每天筛选值得关注的 AI 论文,用工程视角拆解方法、实验和真正的落地价值。
目前已发表 1811 篇文章
一栋楼站在那儿,几十米高,几千个构件。想把它搬进电脑,常见做法是让无人机绕着飞一圈拍上千张照片,再交给算法重建三维模型。
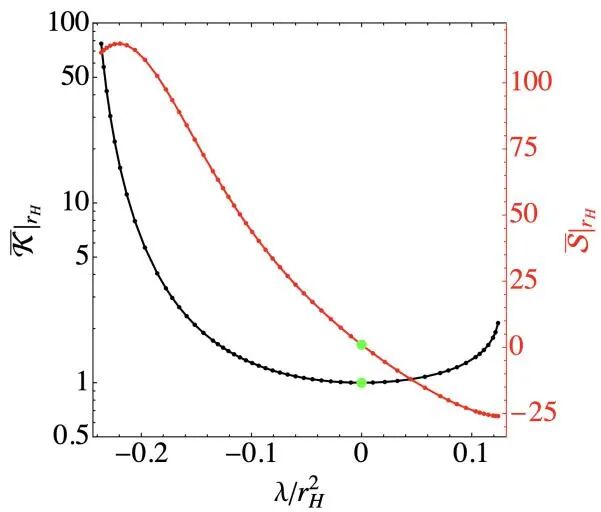
先从一个"面条"说起。四维时空里的黑洞相当老实:旋转的 Kerr 黑洞近年来已经被证明在亚极端情形下是非线性稳定的,意思是稍微推它一下,它晃两晃就回到原来的样子。但维度一加上去,情况立刻不同。
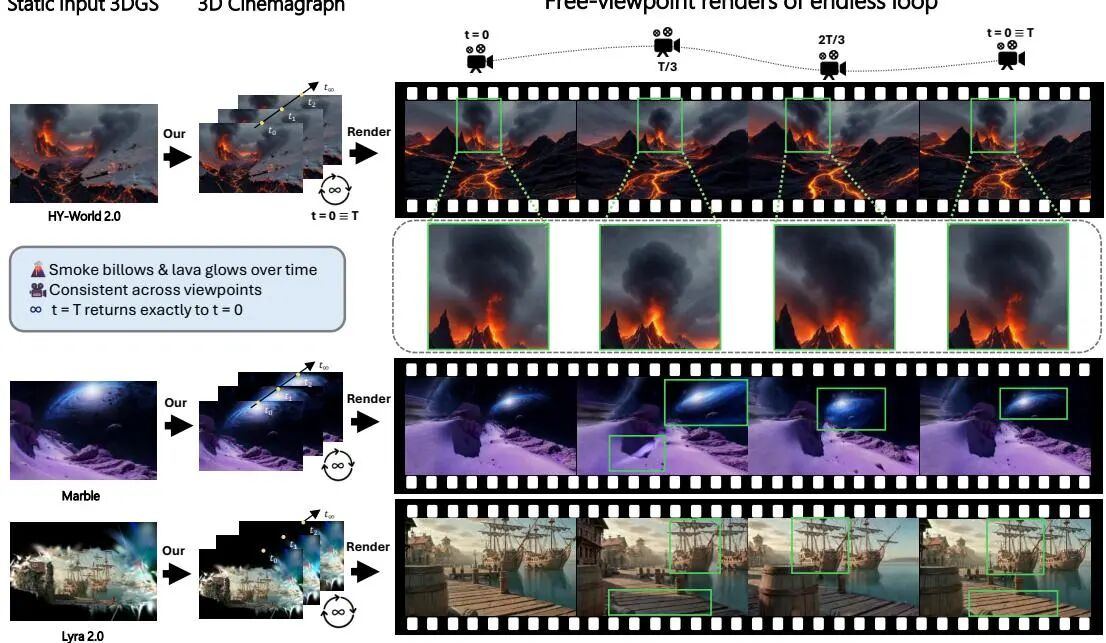
3D世界模型能把一张照片变成可走进去的场景,可这些世界是冻住的:叶子不摇,雾不飘,灯不闪。OuroWorld不用画任何掩膜,让视觉语言模型自己判断什么该动、怎么动,再用傅里叶形变场把首尾严丝合缝地接上。39个场景上全面超越四路基线,30人盲测偏好率70.8%—99%,值得一看它怎么在"互相打架"的脏监督里学出一个干净的4D场景。

传统印象里,CAD建模是工程师坐在电脑前,对着软件菜单点点拖拖,从草图拉伸、切除、倒角一路做到出工程图。
生成一张360度全景图要等半小时?东京大学团队把时间压缩到2分钟,画质还更好,凭什么?

今天这篇来自同济大学的RealCAD,一口气揭了图像转CAD领域两个老底:合成图与真实照片之间的"照骗"差距,以及DeepCAD数据表示里藏着的"刷分捷径"。论文不仅把问题讲透了,还给出了从表示、图像到特征的三层解法,真实域参数精度直接拉升14.73个百分点,值得一读。

现在的数字人头像,脸可以以假乱真,头发却像顶了个头盔——怎么晃都是死的。马普所等机构提出PhysHead,把头发拆成一根根发丝并接入物理引擎,让头像在点头、转头甚至刮风时,头发真的会飘。顺便还借大模型把“秃头版”训练数据造了出来,细节拉满。

3D高斯泼溅遇上开放词汇理解,过去大家往点云里硬塞特征,结果存储爆表、边界糊成一片。北大这篇CVPR 2026新作反其道而行,把几何和语义彻底解耦,用VLM生成文本假设做外置索引,直接让特征存储从GB级砍到MB级。思路清奇,落地极香,值得一读!

单张照片就能告诉机器人“杯子把手在哪、椅子坐哪里”?同济大学与中科院最新开源AfordAny,把开放世界3D功能定位做成了端到端流水线,473类基准直接拉满。

斯坦福在CVPR 2026交出的这份P3Sim答卷,把"世界模型"从玄学拉回了工程:概率图模型+自回归Transformer+几何条件化,三大件拼出一个能从单张图推演3D物理变化的模拟器。新视角合成在SEVA基准上RE10K达到21.54的PSNR,3D物体操作在3DEditBench上PSNR冲到23.12。7月底刚聊过同团队PhyWM,这篇更像是把"懂物

关节物体重建一直是机器人操作里的硬骨头,以前的方法要么依赖关节类型先验,要么遇到螺旋关节就翻车。REArtGS++ 直接拿两张不同状态的多视角 RGB 照片,就把零件级网格、关节参数一起端出来,螺旋关节误差比之前最好的方法降了一个量级,单卡 4090 只要 20 分钟,值得一读。

做光场显微的都知道,帧率和空间信息常常“按下葫芦浮起瓢”。这篇来自UCLA的工作,用Fisher信息把SLIM和FLFM在相同探测器带宽下的账算得明明白白:SLIM用更少的行读出,换来了更高的三维信息效率。做计算成像、显微系统设计或者想优化相机读出架构的朋友,值得一读。
LONGGE AI COMMUNITY
加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。
加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。
 微信扫码加入知识星球