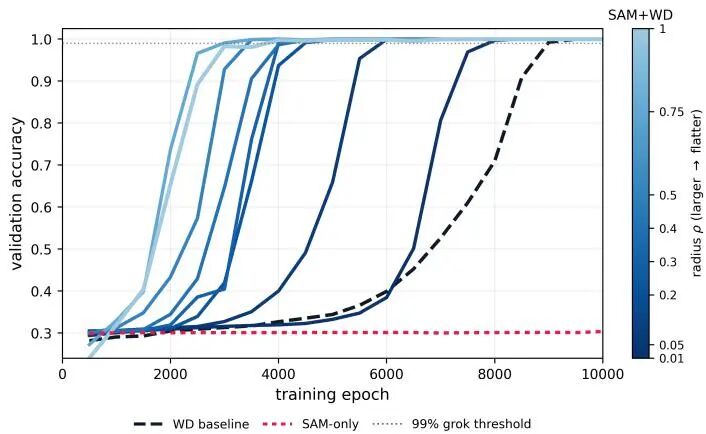
普渡大学新研究:SAM能找最平坦解却不泛化,加速4倍要靠权重衰减
「平坦的最小值更容易泛化」这条被引用了快三十年的经验规律,这次被普渡大学拿出来单独审了一遍。结论有点扎心:用 SAM 硬把解压到最平,模型照样一点儿没泛化;真正把模型从记忆推向泛化的,是权重衰减带来的范数下降,SAM 只是在这个窗口里帮忙踩了一脚油门,把转变加速到最多 4 倍。理论构造那部分尤其漂亮:两种插值的平坦度一模一样,差距全在范数上。
LONGGE AI RESEARCH DAILY
每天筛选值得关注的 AI 论文,用工程视角拆解方法、实验和真正的落地价值。
目前已发表 1811 篇文章
「平坦的最小值更容易泛化」这条被引用了快三十年的经验规律,这次被普渡大学拿出来单独审了一遍。结论有点扎心:用 SAM 硬把解压到最平,模型照样一点儿没泛化;真正把模型从记忆推向泛化的,是权重衰减带来的范数下降,SAM 只是在这个窗口里帮忙踩了一脚油门,把转变加速到最多 4 倍。理论构造那部分尤其漂亮:两种插值的平坦度一模一样,差距全在范数上。
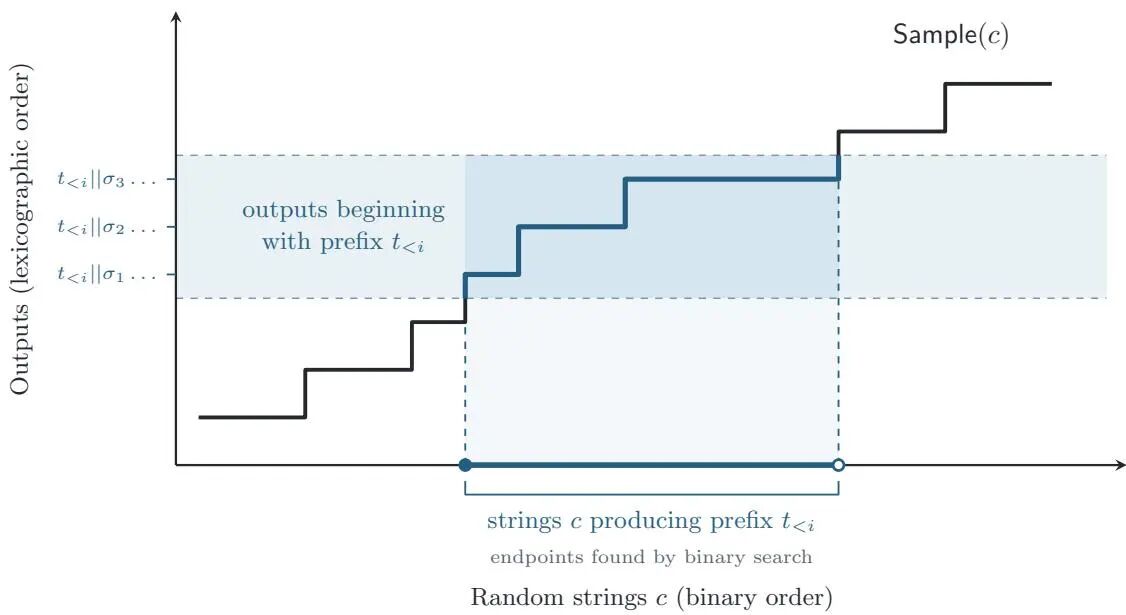
"压缩即智能"这句话流传了很多年,但一直停留在直觉和实验结果上。这篇论文第一次把它写成了定理:语言模型和单调压缩是等价的,误差只差2比特;而一旦去掉"单调"这个条件,等价关系就崩了,除非某个密码学假设不成立。
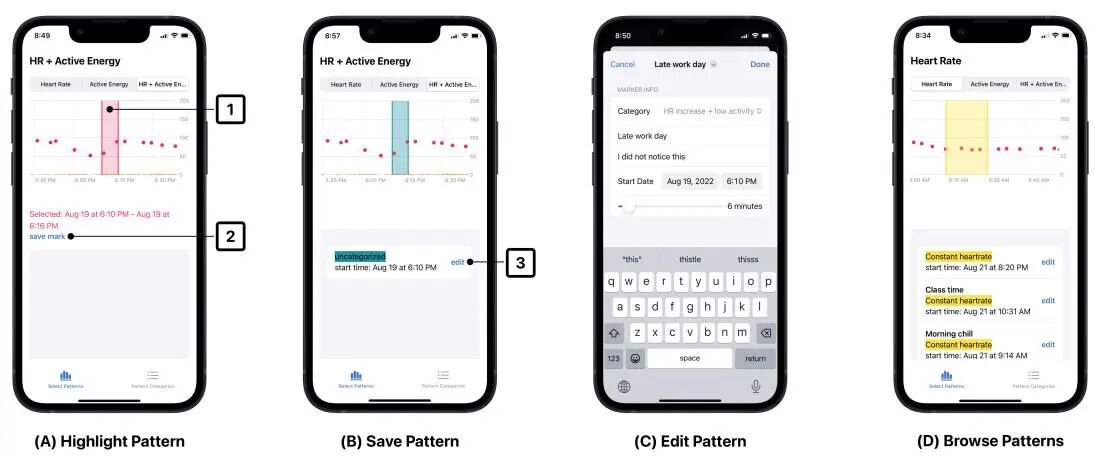
Apple 和斯坦福的这项工作不去比模型分数,而是追问一件更根本的事:当用户终于能自己定义"要让 AI 识别什么",传感系统里那些被写死的本体论边界,真的会被打破吗?8 个人、一周、两个只给界面不给算法的探针,答案比想象中拧巴得多。
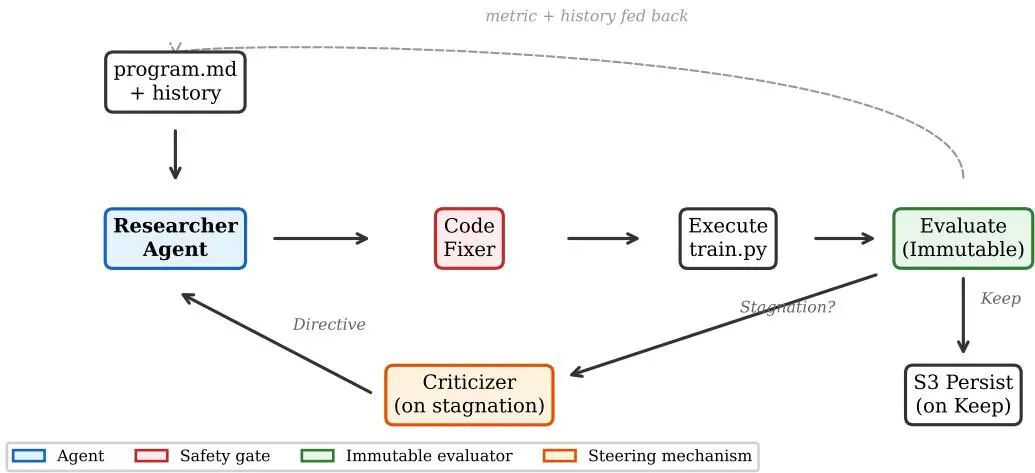
把AutoResearch放进真实生产流水线跑满12周是什么体验?亚马逊给出了答案:220多次实验、多GPU连续烧钱,换来1.82倍和2.1倍的指标提升,也换来五种翻车模式的完整记录,还顺手让代理自己补上了5.8倍的目录覆盖缺口。自主科研的真实边界在哪里,这篇值得花时间读。
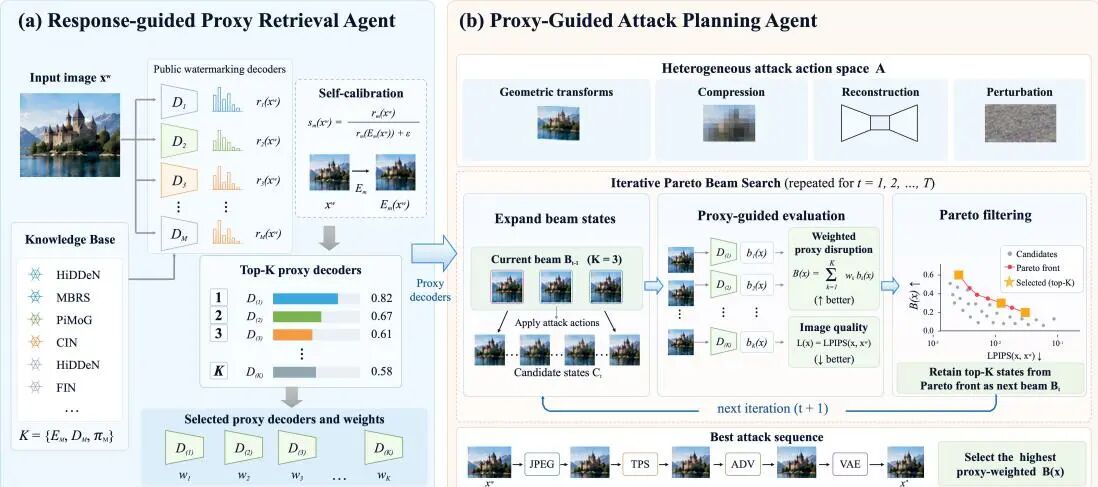
AI生成图片越来越多,水印成了内容溯源的最后一道防线。这篇论文给了一个不太舒服的结论:只要拿到一张水印图,不用知道对方用哪套算法、不碰它的解码器,也能把水印打到接近失效,11套系统平均成功率94.8%。中科大的思路值得细看——拿公开水印模型的解码器当"代理",把开环乱打变成闭环搜索。做水印的要读,做内容治理的更该读。
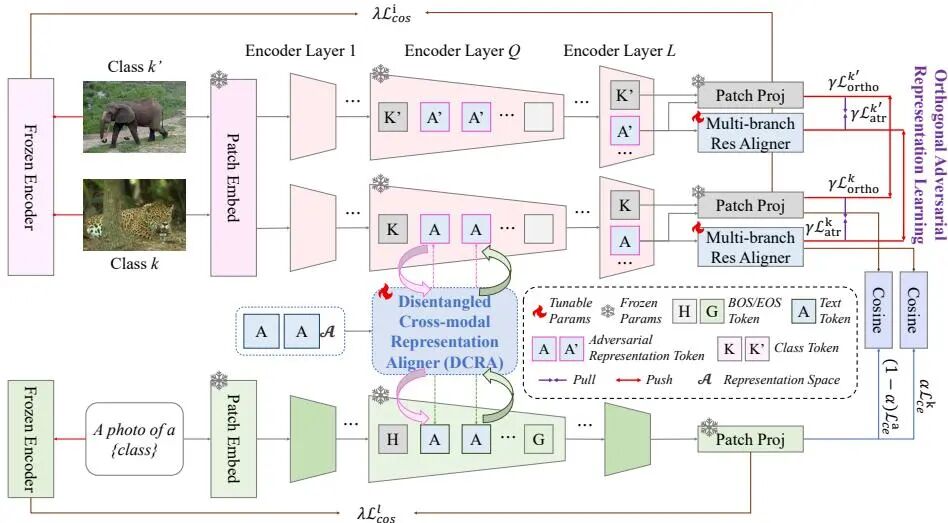
CLIP的提示学习已经被卷了三年,绝大多数工作都在往上叠模块;这篇先停下来问了一句:类特定判别信息和类无关的可迁移知识,是不是从一开始就被搅在同一个特征空间里?齐鲁工大等用解耦跨模态对齐器加正交对抗正则给出一种拆法,15个基准一致涨点,参数量还比上一版少了55.7%。涨点幅度不算炸裂,但这个诊断角度值得花时间读。
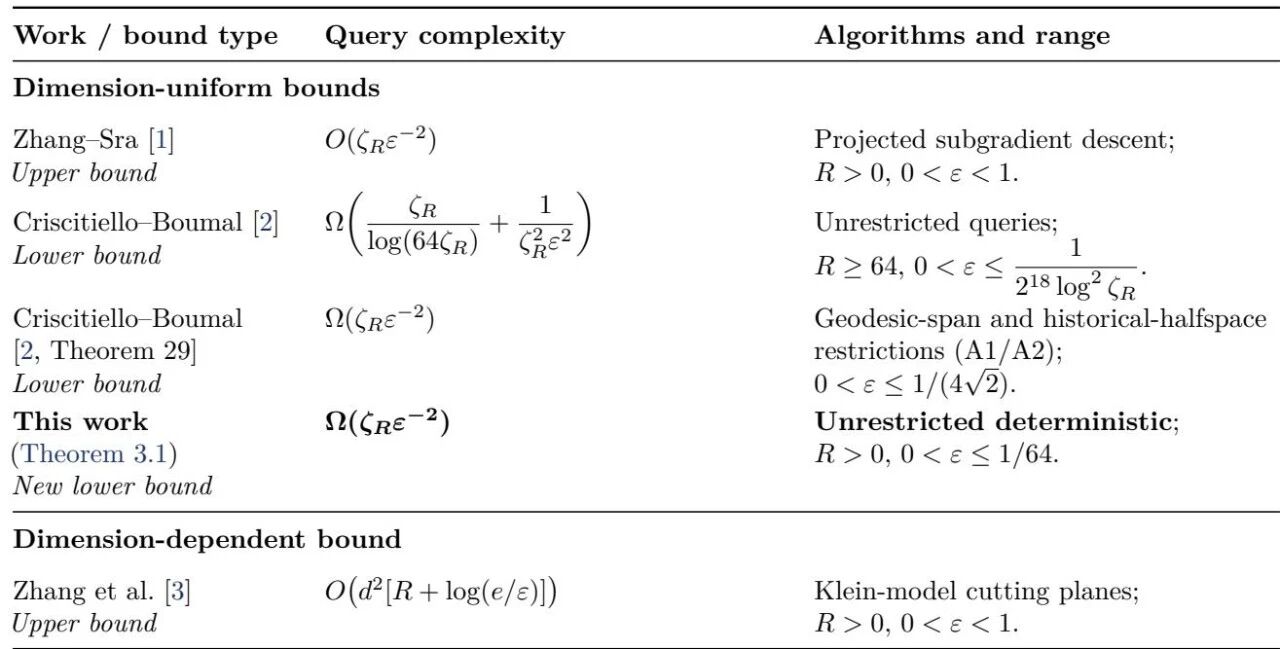
双曲空间里的优化,为什么天生比欧氏空间慢一截?北京大学这篇工作把答案钉死了:在不再给算法加任何额外限制的前提下,查询复杂度就是曲率因子乘以精度代价,曲率那部分躲不掉。上界早有人做出,下界这次终于补齐,中间那道多项式缺口被填平。理论控可以直接入,工程读者也能看清一件事——几何变了,信息代价就得重新算。
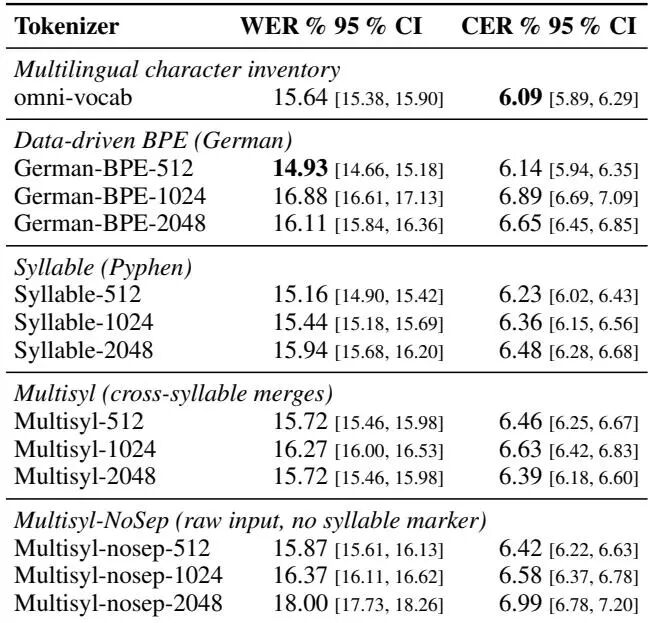
现代端到端语音识别系统(ASR,Automatic Speech Recognition,自动语音识别)的结构很像一条两段式流水线:前面是自监督预训练出来的声学编码器,负责把声音变成表征;
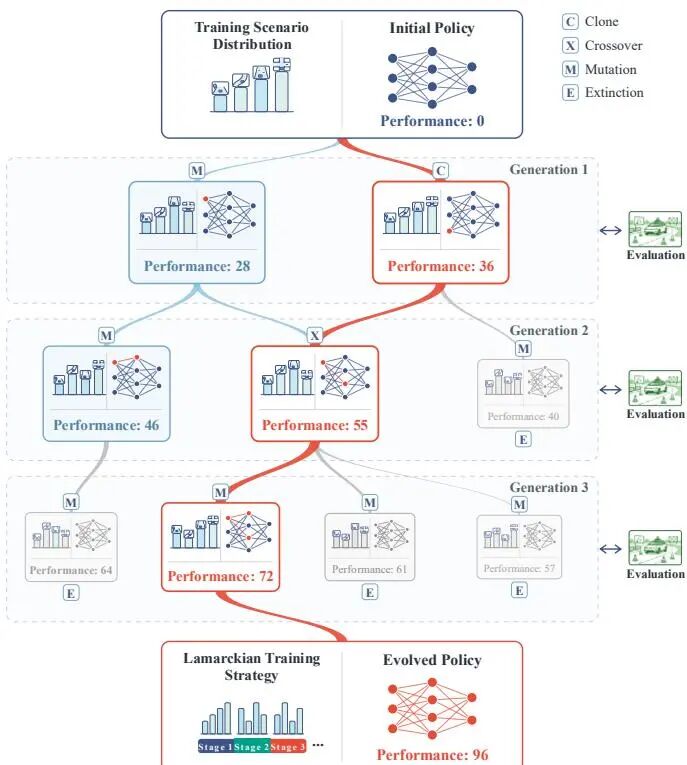
自动驾驶训练里,最容易被当成“背景板”的其实是场景分布。同济大学干脆把它变成会进化的变量:候选场景分布按“训完到底开得好不好”来竞争,优胜路径再蒸馏成一套六阶段轻量课表。完整进化让性能损失比 Replay 降低 25.07%,轻量策略也有 19.13%。
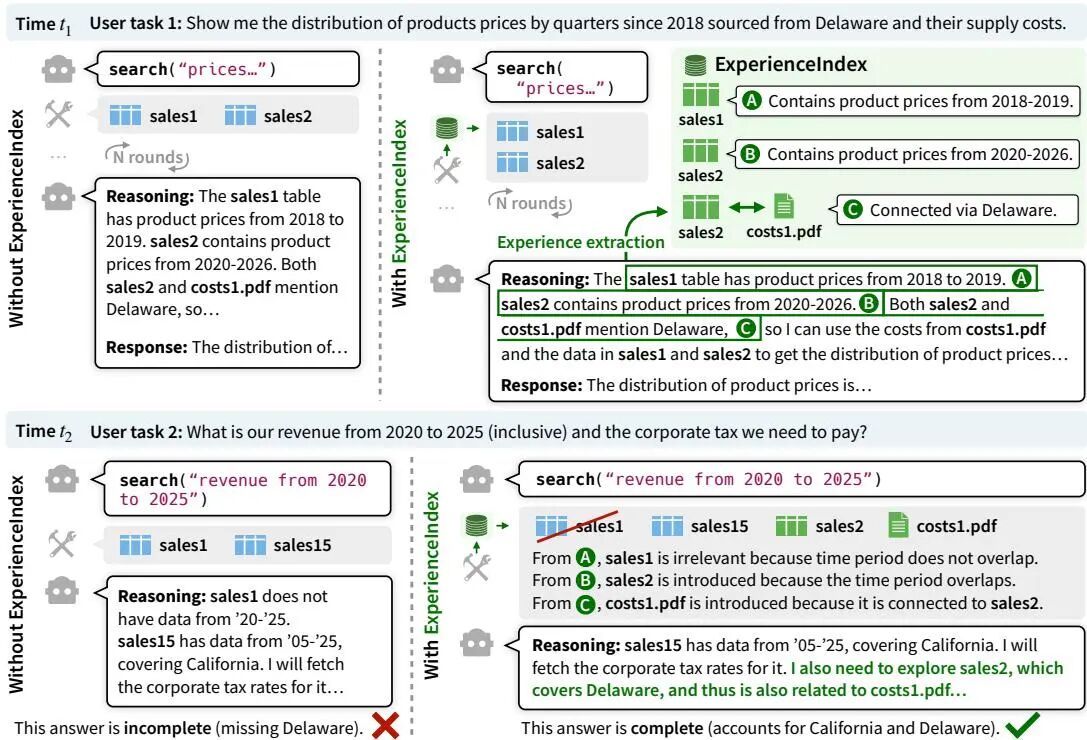
想象一个干了十年的财务顾问,面对杂乱报表,他翻完一遍后脑中会留下便签:“这张表够用”,“那份文件跳过”。下次再来任务,他按便签取该看的东西,既快又准。
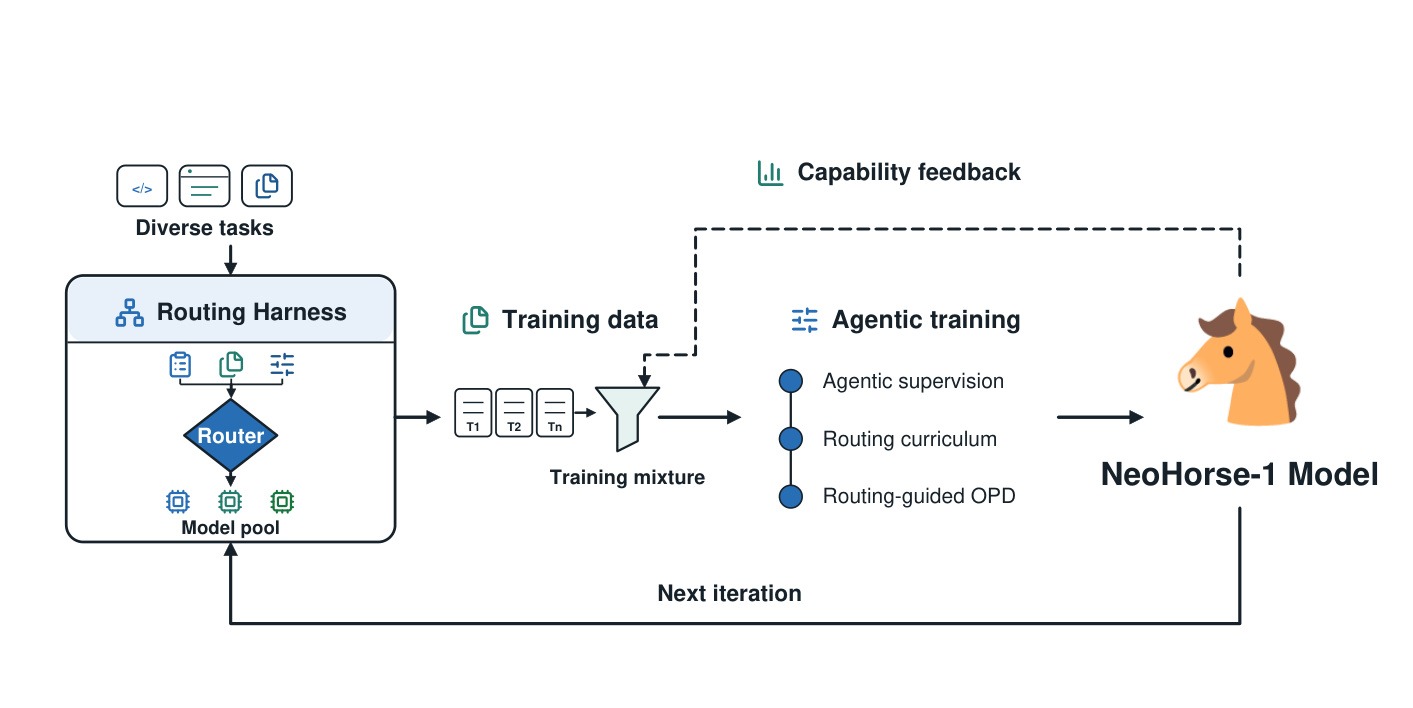
原文标题: NeoHorse-1: Towards Recursive Self-Improvement via Agentic Post-Training with Routing Harness 首次公开: 2026年9月8日(arXiv v1) 主要署名单位: TokenRhythm Technologies 论文: https://arxiv.org

考过程序设计竞赛的读者应该都有同感:决定命运的不是“你觉得自己写对了”,而是评测数据有没有精准戳中你代码里藏得最深的bug。
LONGGE AI COMMUNITY
加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。
加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。
 微信扫码加入知识星球