金斯顿大学:1368种量子网络配置大PK,汇率预测R²达0.985
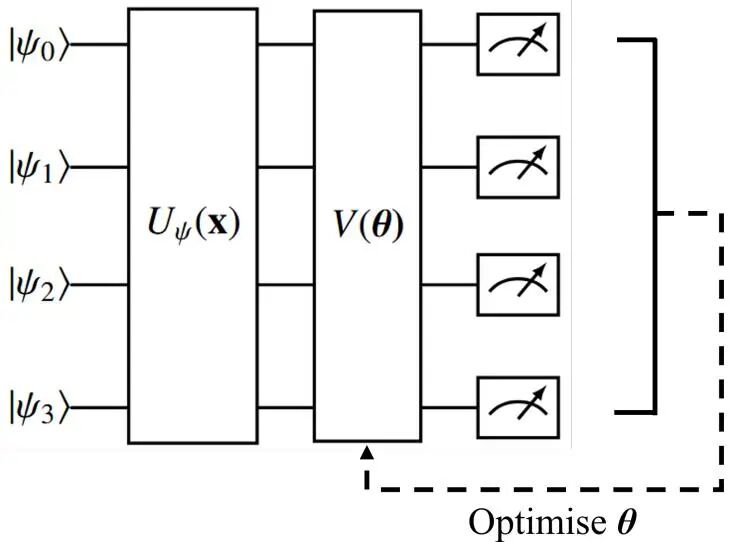
继6月推过金斯顿大学的量子扩散模型之后,同一个团队又把量子神经网络拉出来做了一次全面体检:编码方式、Ansatz、比特数、代价函数全排列组合,1368种配置逐个跑完。模拟环境里最好模型R²冲到0.985,一上真实量子硬件,噪声就把多数配置打回原形。想看量子机器学习当下真实边界在哪,这篇很有料。
LONGGE AI RESEARCH DAILY
每天筛选值得关注的 AI 论文,用工程视角拆解方法、实验和真正的落地价值。
目前已发表 1811 篇文章
继6月推过金斯顿大学的量子扩散模型之后,同一个团队又把量子神经网络拉出来做了一次全面体检:编码方式、Ansatz、比特数、代价函数全排列组合,1368种配置逐个跑完。模拟环境里最好模型R²冲到0.985,一上真实量子硬件,噪声就把多数配置打回原形。想看量子机器学习当下真实边界在哪,这篇很有料。

让AI经理同时考三本“ESG评分教材”,再用高斯过程学习投资经理的内心戏,顺带逛了一圈欧洲、德州等不同“水土”下AI选股的口味差异。谁更爱赚钱,谁更爱地球?量化调参党与ESG信徒都能从中看到自己。

当CEO在财报电话会上闪烁其词,AI能听出他声音里的“虚”吗?KakaoBank等机构构建的双标签基准DualEvasion揭示:大模型在文本回避检测上接近人类,但语音自信度检测最高F1仅58.5,距离人类表现差距巨大。

一套“逻辑回归+梯度提升残差校正”的混合信用评分框架,在东非金融包容数据上精度追平黑箱模型,Brier直降46%,却依旧透明可审计。但公平性审计揭开了另一面:农村、低学历、乌干达用户被路由到“黑箱”ML区域的概率,分别比参照组高出18、32、22个百分点。模型没有制造不平等,却悄悄放大了它。

同样一个因果语言模型,不加回归头、不加策略头,只靠输出token就把三步收益预测和五ETF动态配置全干了;池化净夏普从1.394提到1.494,2025年多模态优势最猛。想看看语言模型怎么绕过"换任务就换头"的套路直接当金融决策接口?这篇值得一读。

把特征拼一起,就像把所有水果丢进一台榨汁机——最后没人知道哪一口是苹果、哪一口是橙子,更不知道是哪个"果"在犯错。西湖大学这篇新工作干脆给残差上"户口":先分清谁的错,再动手修。实测同一批特征、同一批树上限,扣费收益从13.52%干到19.10%、夏普1.42→2.09。这份"残差代数",值得所有做表格学习、量化选股的人细品。
币圈老铁都知道,BIP一改,行情乱跳。但你知道每个政策到底影响了哪些人、影响有多大吗?UCL这篇论文,直接给比特币经济装上了“CT机”,把政策冲击看得明明白白。🤚
龙哥之前吐槽过,AI伦理大多停留在原则文档阶段,无法落地验证。这篇论文直接上Z3求解器,把伦理规则编译成逻辑公式,跑一个sat/unsat就知道系统有没有违规。用金融心理健康数据做案例,验证了知情同意、公平等约束的机器可检查性。虽然还缺真实数据测试,但方向很正——让伦理不再只是文档,而是可执行的代码。
金融模型里最烦的事之一,不是公式长,而是数值一跑就把“正数”跑没了。CIR 这篇就专门盯着这个老问题,把隐式离散方案的弱收敛率补上了严格证明。

这篇论文最有意思的地方,不是又造了一个“更重尾”的噪声,而是直接把问题拆成两半:噪声到底能提供什么,去噪器到底决定什么。结论有点扎心,但很值钱——很多时候,噪声看起来很忙,真正干活的却是条件信息。
无卖空约束一加上“未知市场参数”,很多传统最优解就开始失灵。本文的聪明之处在于:不去硬碰硬做受限随机化,而是把约束放到均值上,用高斯噪声做训练,最后还能把原问题的最优策略捞回来。

金融问答最怕什么?不是题难,是模型一本正经地把账算错。本文直接把“自然语言讲道理”换成“可执行程序讲道理”,再用执行验证筛掉假把式,7B学生竟然能把72B教师按在地上摩擦,思路很硬,结果也很硬。
LONGGE AI COMMUNITY
加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。
加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。
 微信扫码加入知识星球