康斯坦茨大学AI智能体群体行为:复制解释大部分涌现结构
论文基本信息 原文标题: Copying explains the collective behavior of AI agents in the wild 首次公开: 2026年9月8日 署名单位: 康斯坦茨大学、恩里科·费米研究中心、意大利联合圣保罗银行数据与人工智能办公室、维也纳复杂性科学中心 原论文链接: https://arxiv.org/abs/
LONGGE AI RESEARCH DAILY
每天筛选值得关注的 AI 论文,用工程视角拆解方法、实验和真正的落地价值。
目前已发表 1811 篇文章
论文基本信息 原文标题: Copying explains the collective behavior of AI agents in the wild 首次公开: 2026年9月8日 署名单位: 康斯坦茨大学、恩里科·费米研究中心、意大利联合圣保罗银行数据与人工智能办公室、维也纳复杂性科学中心 原论文链接: https://arxiv.org/abs/
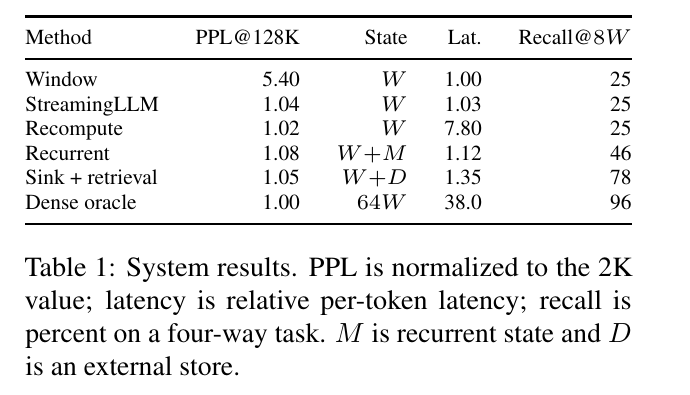
论文基本信息 原文标题: Separating Stream Stability from Long -Term Recall in Language Models 首次公开: 2026年9月7日 署名单位: 广西大学、重庆交通大学、广东工业大学 https://arxiv.org/abs/2609.07282
论文基本信息 原文标题: P r i v E s c a l a t e : Measuring and Augmenting the Threat of L L M - A u t o m a t e d Linux Privilege Escalation 首次公开: 2026年9月8日 署名单位: 新加坡南洋理工大学、西安交通大学 会议: 2026年计
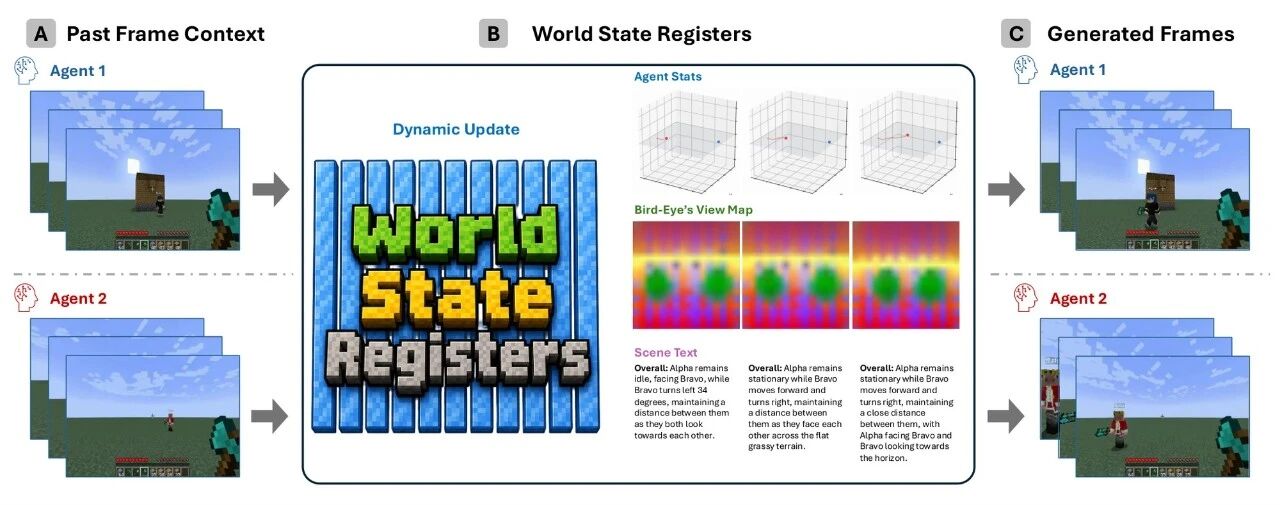
论文基本信息 原文标题: 多智能体自回归扩散模型与世界状态寄存器(Streaming Multi-Agent Autoregressive Diffusion Model with World State Registers) 首次公开: 2026年7月23日 署名单位: 加州大学洛杉矶分校、Adobe Research 原论文: https://arxiv
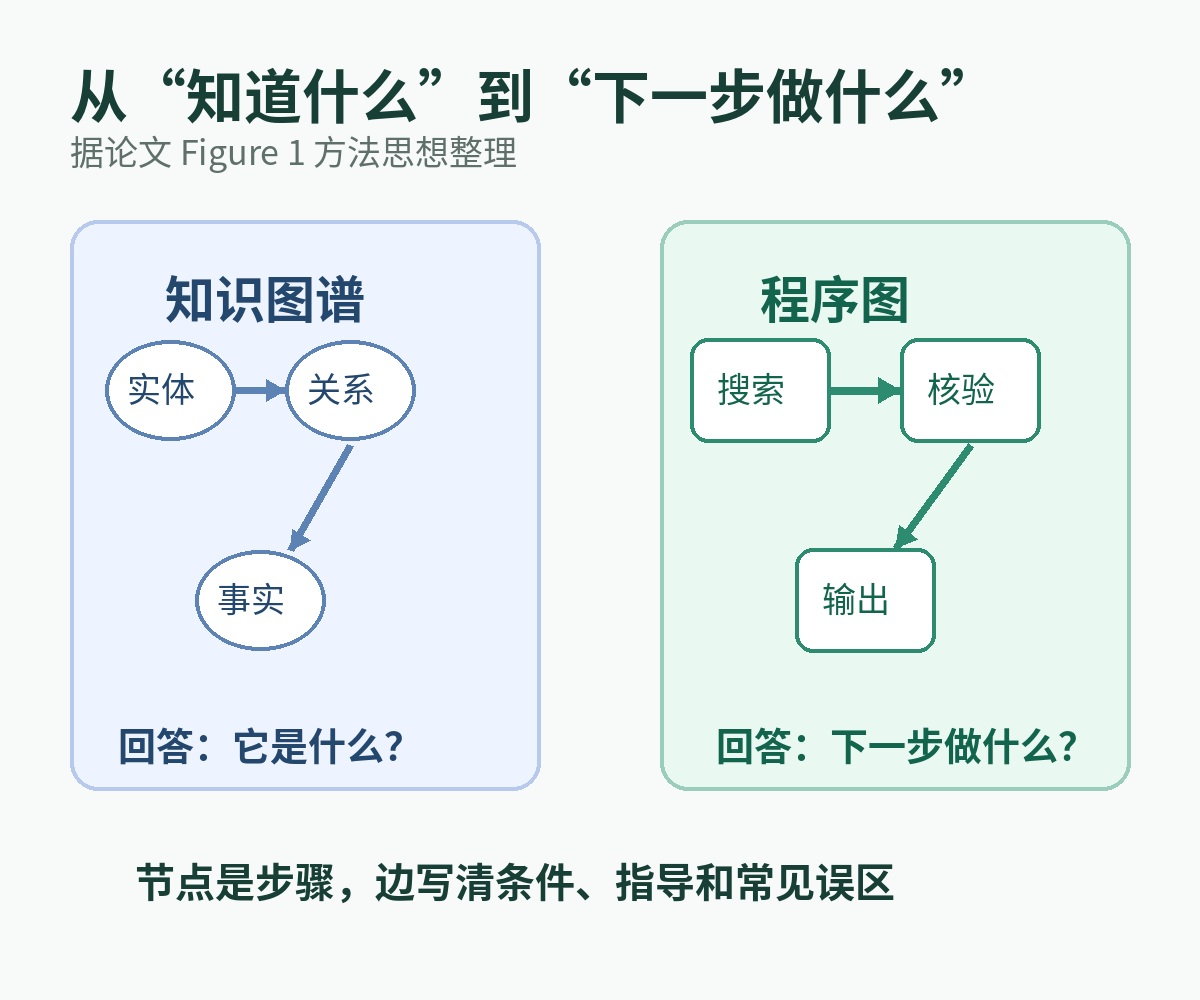
原文标题: Procedural Graphs: Self- Evolving Execution Structures for L LM Agents 首次公开: 2026年9月8日(arXiv v1) 署名单位: 谷歌、佐治亚理工学院、北京大学 研究领域: 大语言模型智能体、工具调用、长程规划、程序性记忆 原论文: https://arxiv.org/a
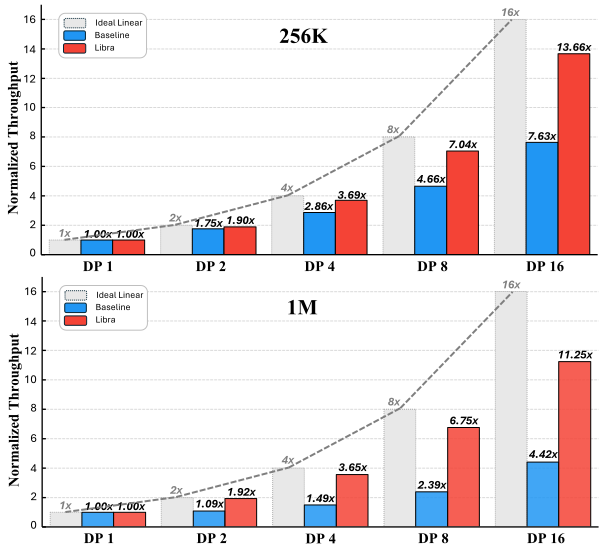
原文标题: Libra: Taming Attention Workload Skew in Long-Context LLM Training with Bounded Sequence Pool 首次公开: 2026年7月25日 署名单位: 中国科学院大学、阿里巴巴集团、新加坡国立大学 核心术语: 长上下文训练(Long-Context)、大语言模型(L
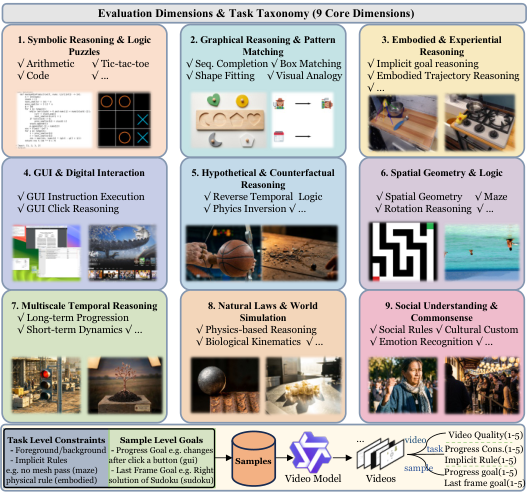
原文标题: “以视频思考”方法(Think-with-Video)对应原文题名:From Evaluation to Enhancement: Benchmarking and Improving Think-with-Video Reasoning for Video Generative Models 首次公开: 2026年9月10日 署名单位: 新加坡

原文标题: RoboFolDeX: A Physical-World Benchmark for Long-Horizon Robotic Manipulation of Deformable Objects 首次公开: 2026年9月9日 署名单位: 复旦大学、美的集团(上海)人工智能研究中心、卡内基梅隆大学 原论文: https://arxiv.org/
原文标题: VISTA: A Visual Harness for Reasoning in an Interactive World 首次公开: 2026年10月1日 署名单位: 麻省理工学院 知名研究者: 何恺明团队 原论文: https://arxiv.org/abs/2610.02200 项目主页: https://vista-research.gi
原文标题: Video DeltaNet: A Video-Native Hybrid Attention for Livestream Video Generation 首次公开: 2026年9月17日 署名单位: 加州大学伯克利分校、Impossible公司、得克萨斯大学奥斯汀分校 原论文: https://arxiv.org/abs/2609.2074
原文标题: Programmable World Model 首次公开: 2026年9月10日 署名单位: Alaya Lab 原论文: https://arxiv.org/abs/2609.10540 项目页: https://alaya-lab.github.io/pwm 开源代码: https://github.com/AlayaLab/pwm
很多世界模型都在追求更大、更密、更强的潜变量和预测器。这篇工作偏偏反过来问:如果让大量潜变量维度直接归零,只保留少数活跃维度,未来会不会反而更好预测?纽约大学与AMI Labs团队给出的答案很有意思:在困难的PushT规划任务中,稀疏表示没有包打天下,却让中等容量预测器相对稠密基线提高24%—57%的规划成功率。真正值得看的,不只是“57%”这个数字,而是它
LONGGE AI COMMUNITY
加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。
加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。
 微信扫码加入知识星球