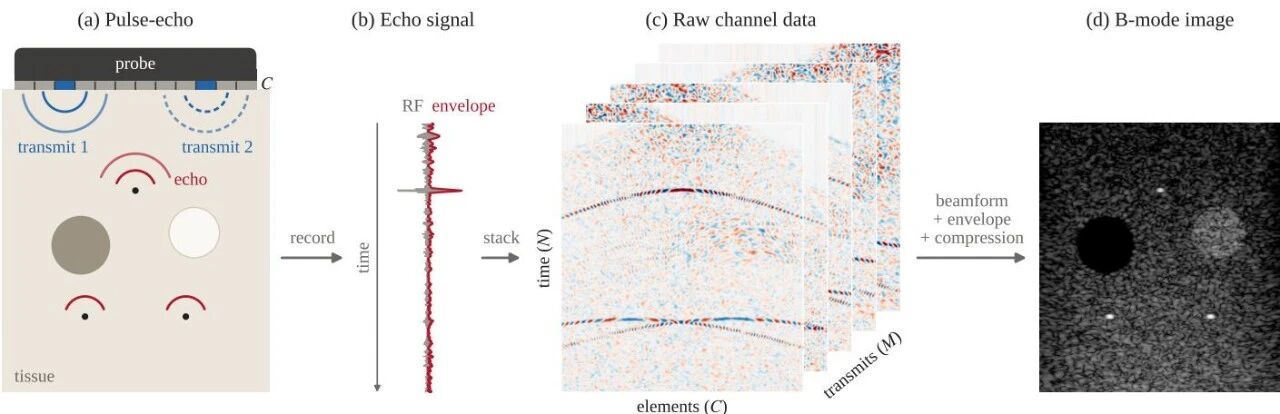
全球最大超声原始通道数据集:斯坦福×英伟达等38家机构开源40TB
超声原始通道数据一直是块硬骨头:临床机器不给导,各家格式各说各话,一次采集动辄几个G。这篇把38家机构的约40TB数据拧成一个统一格式的开放语料,19,332次采集、覆盖从波束形成到血流成像再到智能诊断的十几类任务,算是给超声基础模型铺了块实打实的地基。
LONGGE AI RESEARCH DAILY
每天筛选值得关注的 AI 论文,用工程视角拆解方法、实验和真正的落地价值。
目前已发表 1811 篇文章
超声原始通道数据一直是块硬骨头:临床机器不给导,各家格式各说各话,一次采集动辄几个G。这篇把38家机构的约40TB数据拧成一个统一格式的开放语料,19,332次采集、覆盖从波束形成到血流成像再到智能诊断的十几类任务,算是给超声基础模型铺了块实打实的地基。
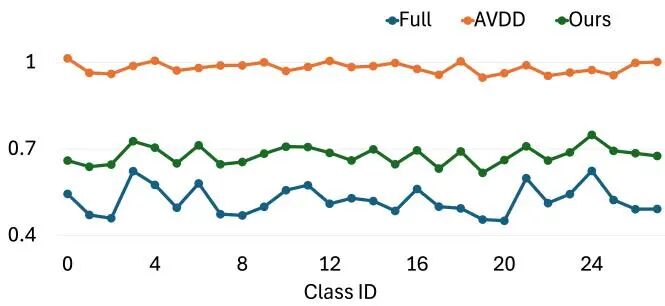
数据集蒸馏这名字听着很美:用一小撮合成样本,顶掉整个大训练集。可一到音视频这种双模态场景,就撞上两根硬钉子——显存炸裂,以及两个模态各说各话。印度理工海得拉巴分校这篇 X-AVDD 用双向交叉注意力把两件事一起收拾了:合成时间从10小时压到1.3小时,VGGSound 上的准确率从个位数跳到两位数。这波值得拆开看看。
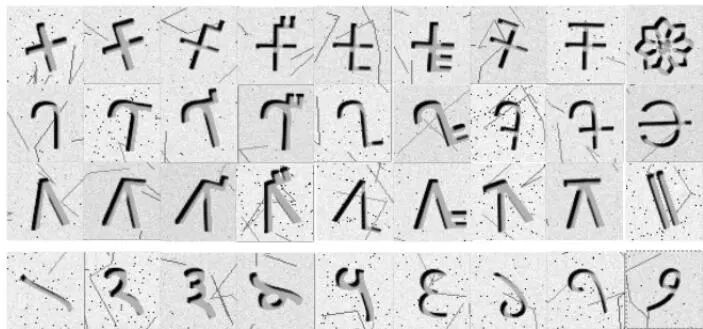
让AI去读两千多年前刻在石头上的字,听起来像考古队的活儿,可印度理工学院甘地讷格尔分校真把它做成了流水线:图像增强、字符识别、转写、翻译一步不落,还顺手开源了25.38万张字符图和2224对双语语料。方法不花哨,但“没数据”这个老大难被正面解决了,值得一看。
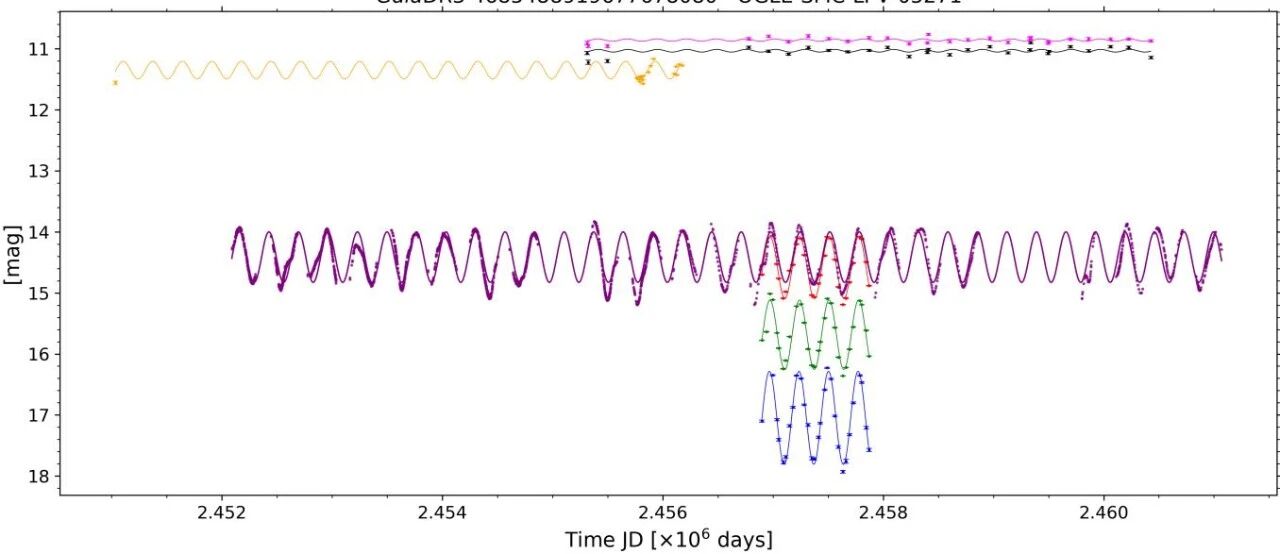
米拉变星是渐近巨星支上的大振幅脉动变星,周期性地膨胀和收缩,抛出外层物质。
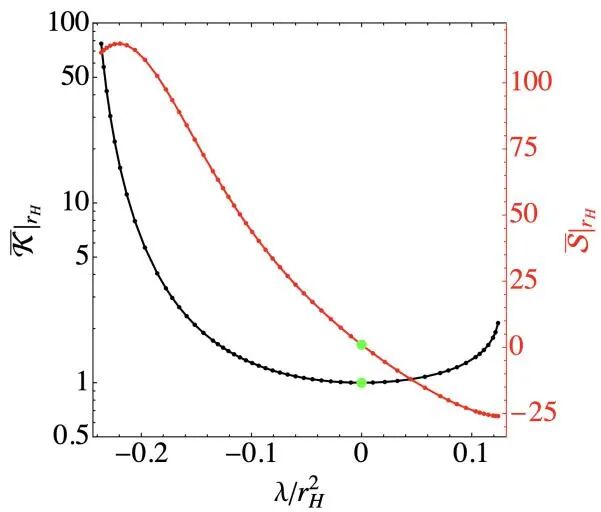
先从一个"面条"说起。四维时空里的黑洞相当老实:旋转的 Kerr 黑洞近年来已经被证明在亚极端情形下是非线性稳定的,意思是稍微推它一下,它晃两晃就回到原来的样子。但维度一加上去,情况立刻不同。
一个可视化平台宣称自己算出来的数字和手写脚本一样,这话到底该不该信?Nimbus BCI 给出的答案是:六条经典脑电解码流水线,三个公开数据集,两种评估协议,平台引擎与独立手写实现各跑一遍,逐被试比准确率。确定性流水线全部 0.00 点一致,深度模型的差异落在训练种子噪声里。软件平台自己做验证研究,这事本身就少见,值得看一眼它的验证设计和边界。
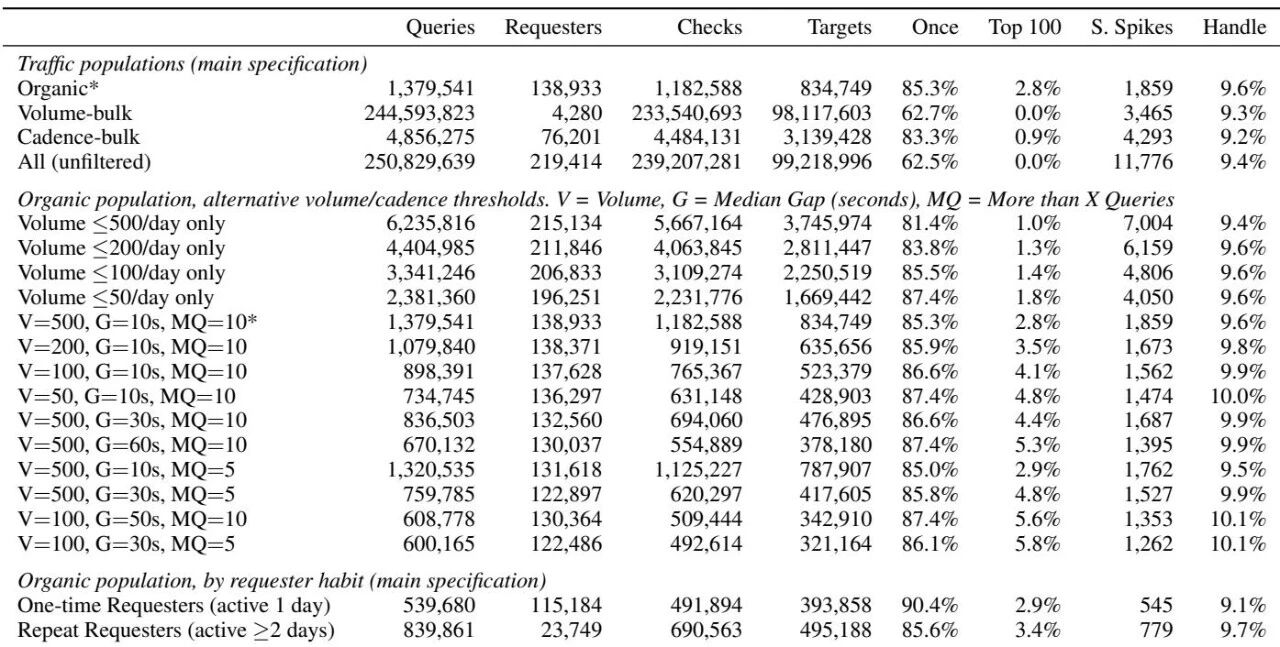
凌晨一点,你刷到一条推文:语法完美、情绪饱满、主页挂着三个外链和一份加密货币白皮书,而且它已经连续发了十四个小时。你盯着屏幕两秒,脑子里冒出一句话:这账号是不是机器人?
去中心化知识图谱听着很美,真去查能让人崩溃:引擎得顺着链接一根根摸,HTTP 请求一发一大把。这篇论文给查询引擎发了张"地图",也就是 RDF 形状索引——先看地图再走路,无关的房子根本不用敲门。最快提速 7 倍,一个原本怎么都跑不完的查询,现在跑通了。

先来看一种并不罕见的场景:在产品包装设计、店铺招牌生成、设备铭牌渲染这类视觉内容创作任务里,用户往往给模型下达一个明确指令——在某个指定的主体区域(比如一家面包店的招牌、一辆货车的车身、一瓶饮料的标签)写入指定的文字,同。

让AI画“时间就是金钱”,它可能真画一个挂满钞票的时钟;让AI画“知识就是力量”,它又可能把书本和哑铃硬拼在一起。文生图模型能把物体画得很真,却常常画不出“画外之音”。同济大学等机构提出VMetaphor-Bench,把“视觉隐喻生成”这件事第一次系统性地量化评测,结果连GPT Image 1.5也栽在结构组合上。

当所有文生图评测还在卷画质和指令跟随,UIUC这次直接把“答案藏在图里”的推理题丢给模型。2000道题、9个主流生成模型,最强Gemini 3 Pro也只拿64.6分。想看生成模型到底有多少“真推理”,这片试金石值得收藏。

无线胶囊内镜拍出来的图常常模糊不清,而真实场景下几乎不可能拿到一一配对的清晰与模糊图对。这篇来自印度SVNIT与挪威NTNU的工作把Transformer放进无监督GAN里做四倍超分,还顺手提出了一个内镜专用的无参考画质指标,代码与预训练模型均已开源,值得做医学影像增强的读者仔细看看。
LONGGE AI COMMUNITY
加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。
加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。
 微信扫码加入知识星球