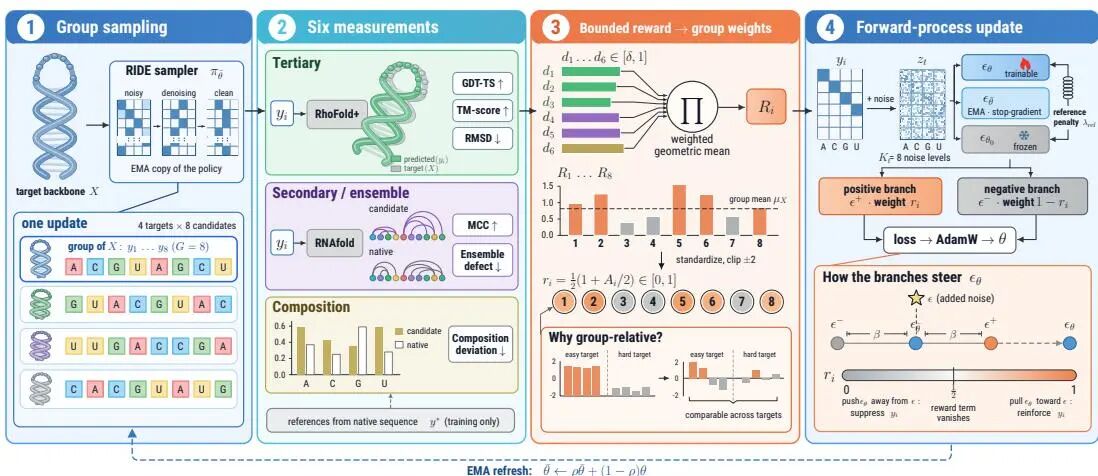
复旦大学MORAD:六维奖励让RNA逆设计GDT-TS涨16.0%
RNA逆设计是先定三维结构,再找能折叠成该结构的序列。
LONGGE AI RESEARCH DAILY
每天筛选值得关注的 AI 论文,用工程视角拆解方法、实验和真正的落地价值。
目前已发表 1811 篇文章
RNA逆设计是先定三维结构,再找能折叠成该结构的序列。
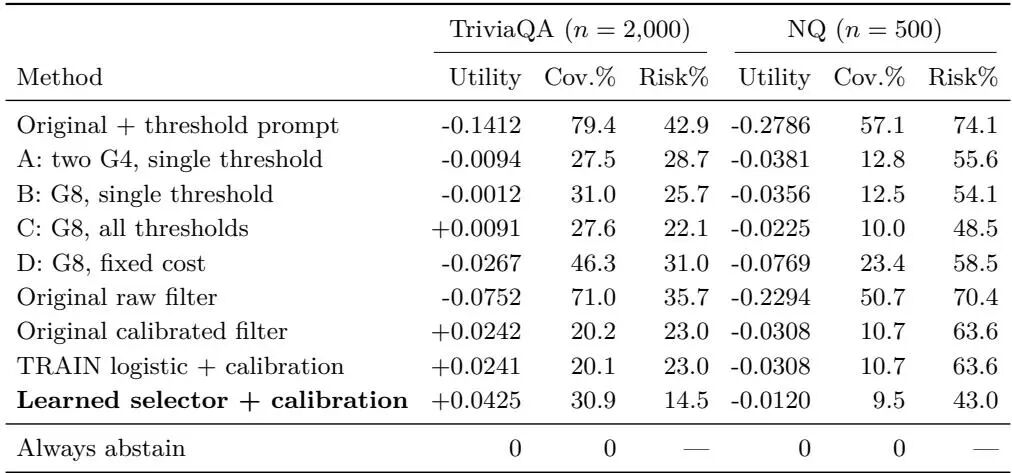
先讲一个大家都踩过的坑。你问一个模型某个偏门的事实问题,比如某本小众小说里配角的全名,或者某个 1998 年的会议在哪座城市举办,模型张口就来,语气笃定、句式工整、标点齐全——一查,全是编的。
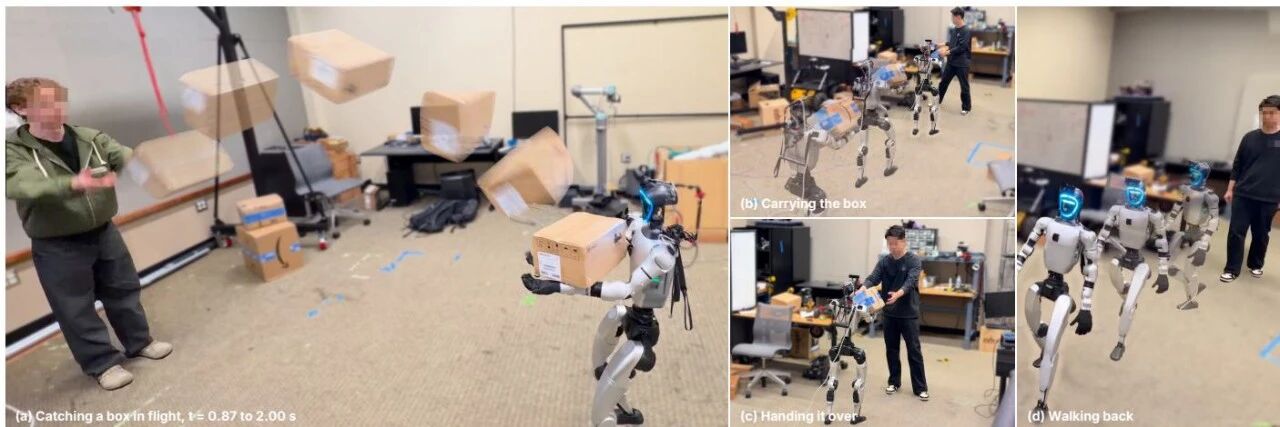
接住一个扔过来的东西,人类基本不用想。回追一个网球、接住从桌边滑落的杯子、侧身躲开推车、搬货时顺手接住同伴抛来的纸箱,这些动作有一个共同点:目标在动,留给你的反应时间大约只有一秒,而且要用整个身体去接,而不只是伸手。
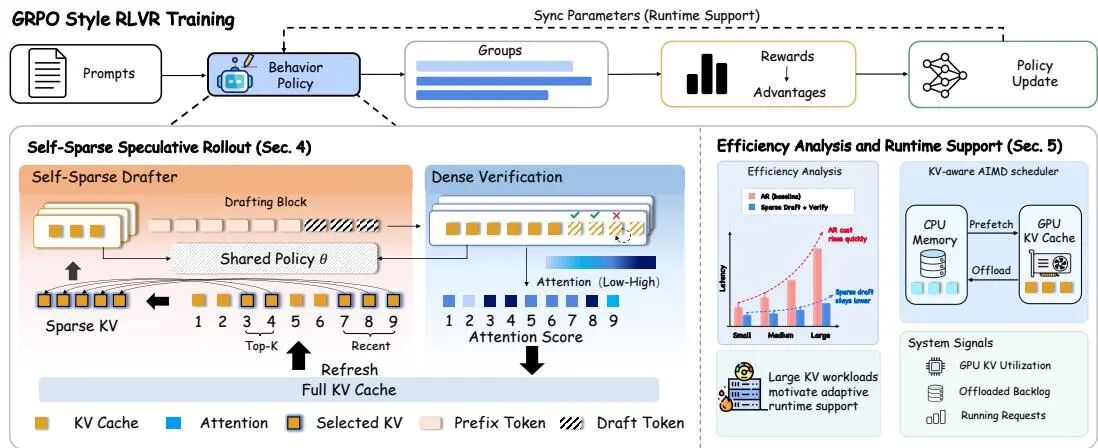
大模型做强化学习,真正的瓶颈常常不在反向传播,而在 rollout 生成——注意力吃掉了七成以上的解码时间。港科大(广州)这篇 S3R 的做法挺取巧:稀疏注意力只负责"提词",全注意力负责严格验收,采样分布不动,KV 读取却大幅减少。Qwen3-1.7B 上端到端训练吞吐做到 1.39 倍,训练还更稳。
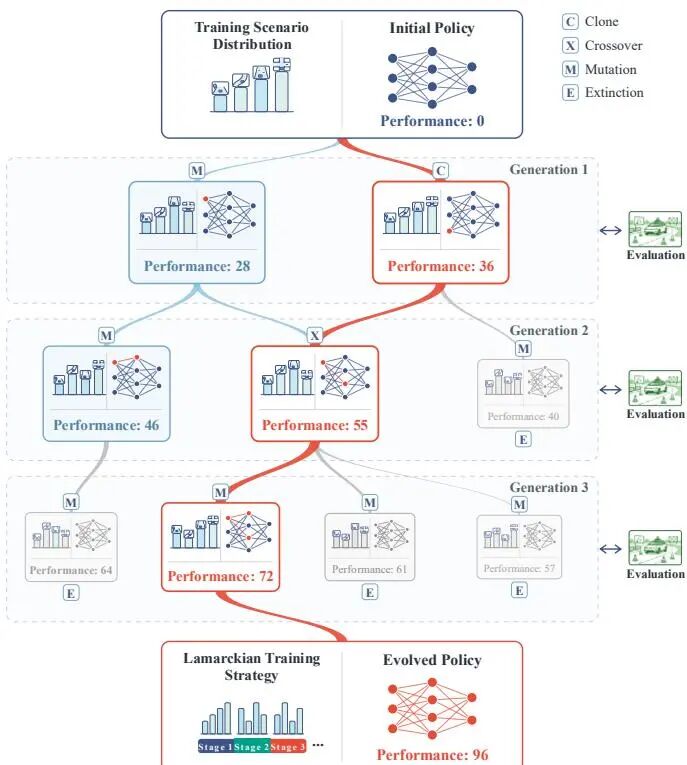
自动驾驶训练里,最容易被当成“背景板”的其实是场景分布。同济大学干脆把它变成会进化的变量:候选场景分布按“训完到底开得好不好”来竞争,优胜路径再蒸馏成一套六阶段轻量课表。完整进化让性能损失比 Replay 降低 25.07%,轻量策略也有 19.13%。
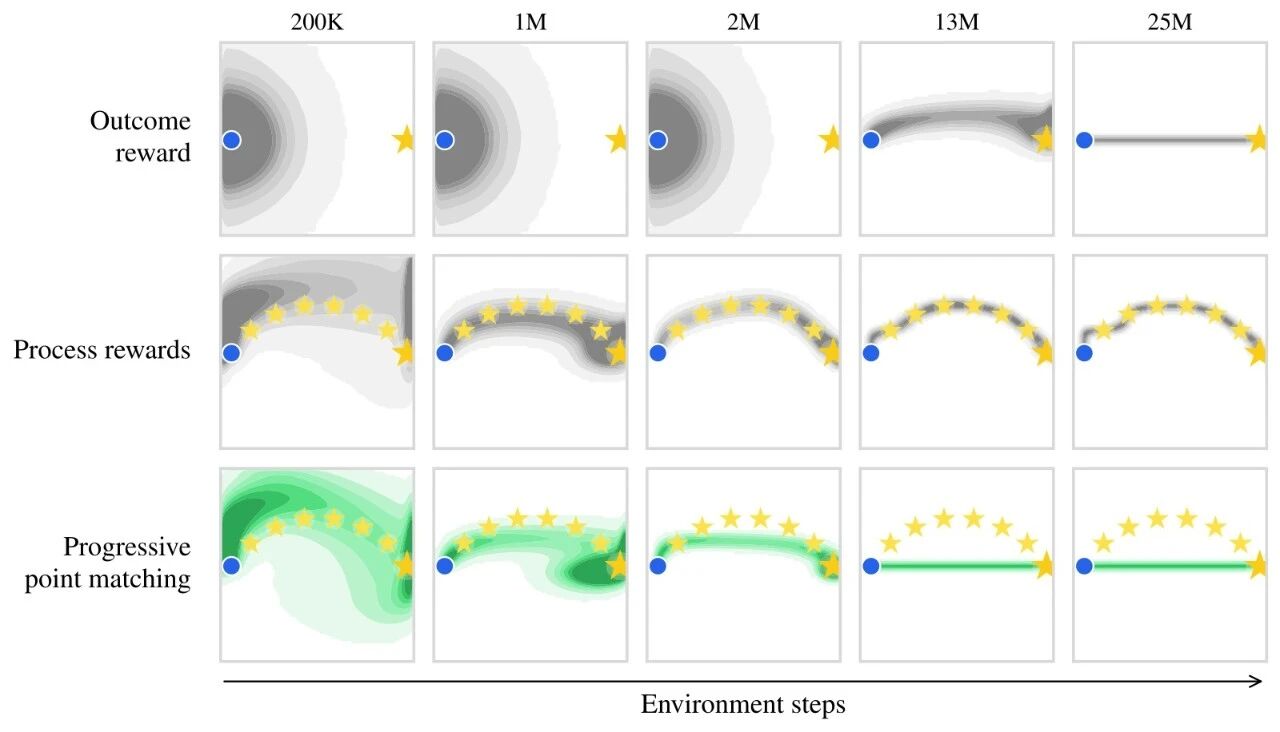
论文基本信息 原文标题: Long‑Horizon Language Model Reinforcement Learning via Progressive Point Matching 首次公开: 2026年9月7日 署名单位: 加州大学伯克利分校、卡内基梅隆大学 原论文链接: https://arxiv.org/abs/2609.07303
论文基本信息 方法名称: 合成奖励因果探索训练框架(TRACE) 原文标题: TRACE: Training Reasoning Agents for Causal Exploration with Synthesized Rewards 首次公开时间: 2026年9月9日 署名单位: 独立研究者 作者: Rui Sun、Zhan Shi、Bing He 研
论文基本信息据官方论文与项目页整理;正文不展示普通作者姓名。
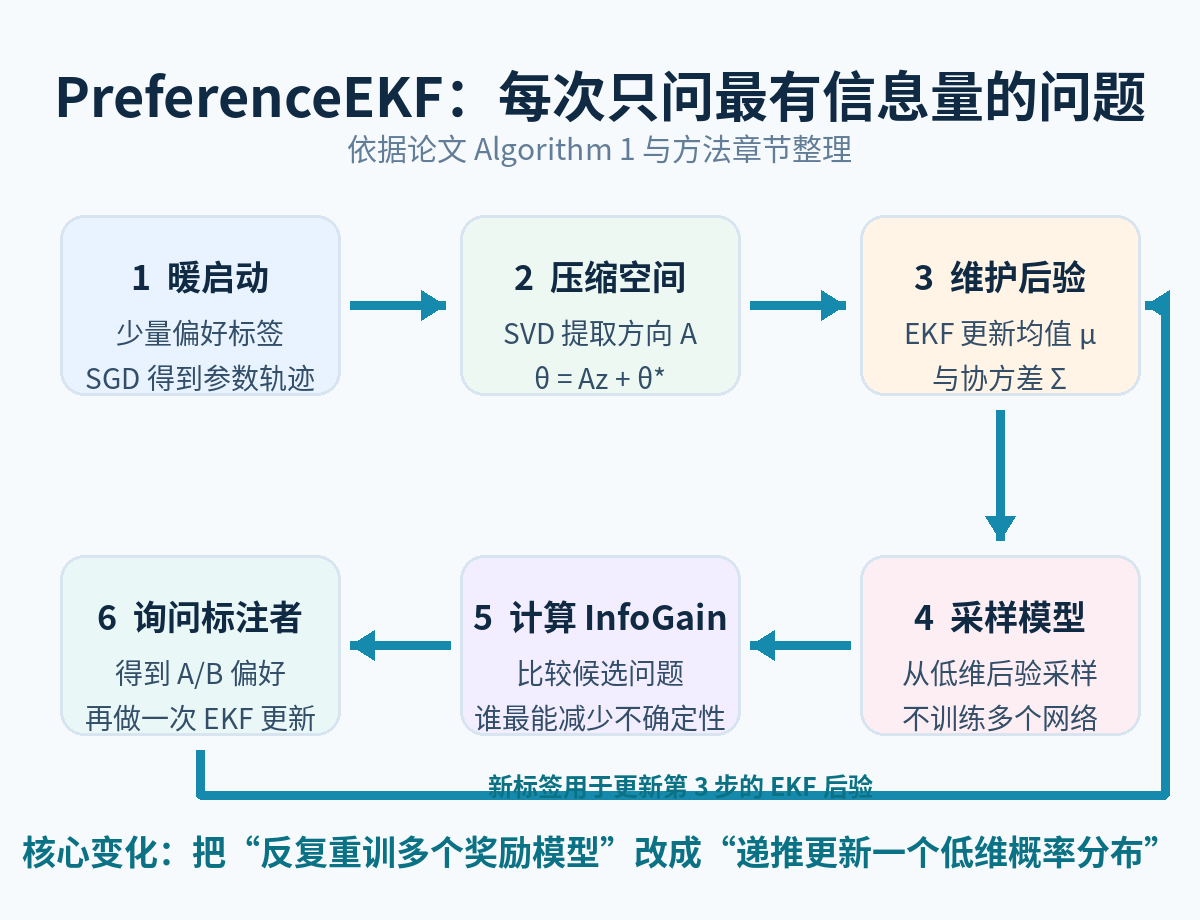
论文基本信息 原文标题: Subspace Inference Enables Efficient Active Reward Learning from Preferences 作者: Yutai Zhou、Erdem Bıyık 作者单位: University of Southern California(南加州大学) 首次公开: 2026年9月3日(
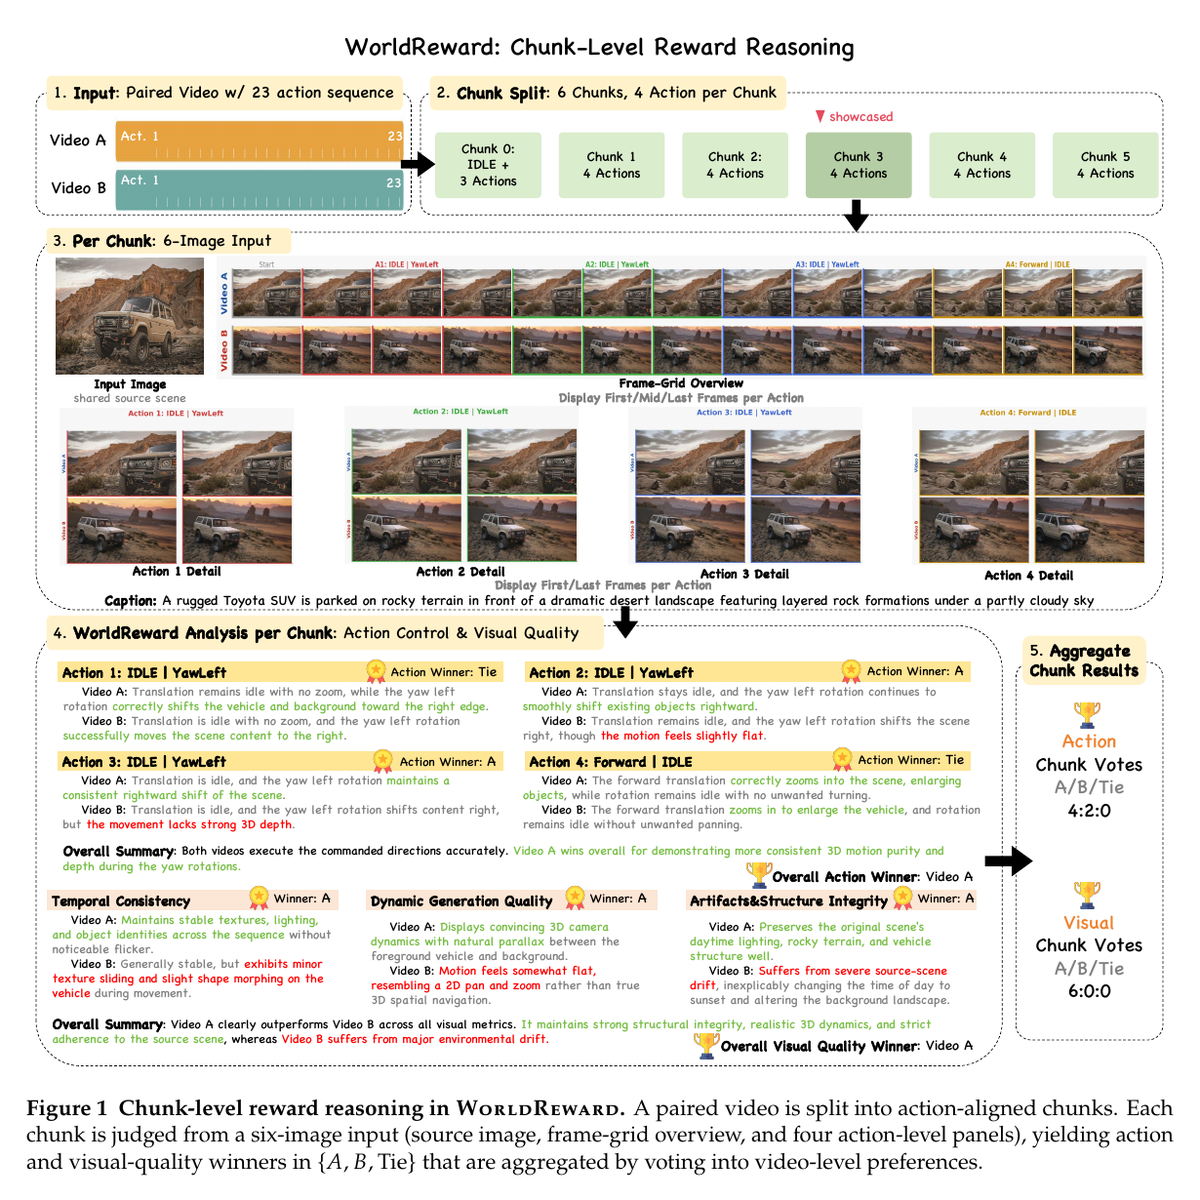
世界模型生成的视频越来越逼真,但它可能一边把画面做得很漂亮,一边悄悄执行错了相机指令。复旦、腾讯混元、上海创智学院、上海交大和上海人工智能实验室等团队提出 WorldReward:不再只看单帧美不美,而是逐段检查“动作有没有做对、画面有没有崩”。在 760 对人工标注视频上,它对动作、外观和运动质量的判断一致率分别达到 77.63%、81.32% 和 73.

还在让代码大模型硬啃题目?上海交大等机构提出的TIPCODER做了个示范:先别急着写代码,让模型根据具体问题"出个主意",再动笔。就这么一个前置小动作,一次生成的效果反超了Best-of-8的多次采样,平均通过率最高冲到71.10,有点东西。

考过程序设计竞赛的读者应该都有同感:决定命运的不是“你觉得自己写对了”,而是评测数据有没有精准戳中你代码里藏得最深的bug。
LONGGE AI COMMUNITY
加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。
加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。
 微信扫码加入知识星球