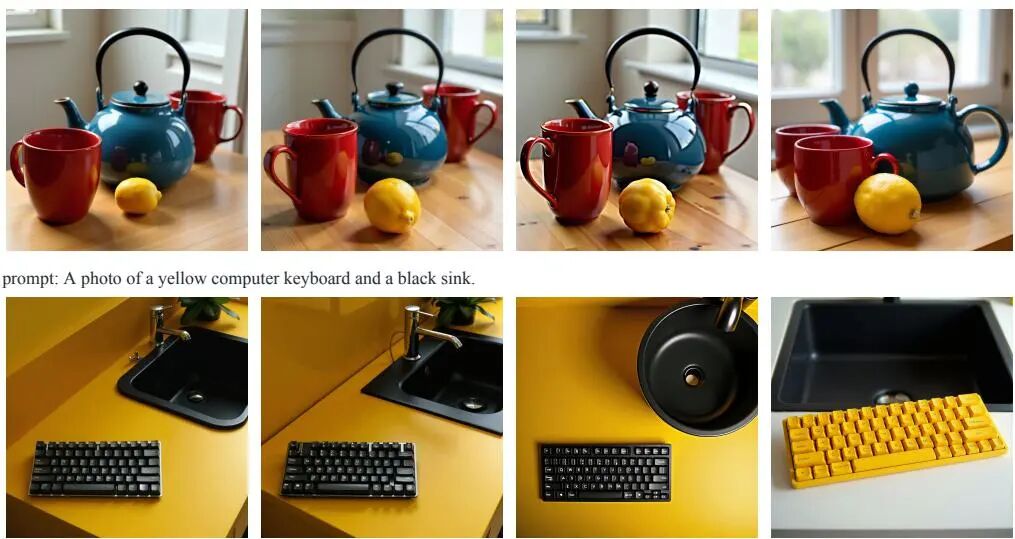
斯坦福&清华提出SFG:压制图像反馈,FLUX文生图GenEval涨至0.7479
文生图模型里藏着一个不太被讨论的回路:图像会通过联合注意力,把自己的内容"回写"到内部文本流里。问题是,这个反馈到底在纠错,还是在保留错误?斯坦福、清华的这篇论文用移植实验给出了答案,并顺手做了个叫 SFG 的训练无关引导,让 FLUX 的 GenEval 从 0.6661 涨到 0.7479。不改权重、不重训,推理期就能用,值得花时间看看。
LONGGE AI RESEARCH DAILY
每天筛选值得关注的 AI 论文,用工程视角拆解方法、实验和真正的落地价值。
目前已发表 1811 篇文章
文生图模型里藏着一个不太被讨论的回路:图像会通过联合注意力,把自己的内容"回写"到内部文本流里。问题是,这个反馈到底在纠错,还是在保留错误?斯坦福、清华的这篇论文用移植实验给出了答案,并顺手做了个叫 SFG 的训练无关引导,让 FLUX 的 GenEval 从 0.6661 涨到 0.7479。不改权重、不重训,推理期就能用,值得花时间看看。
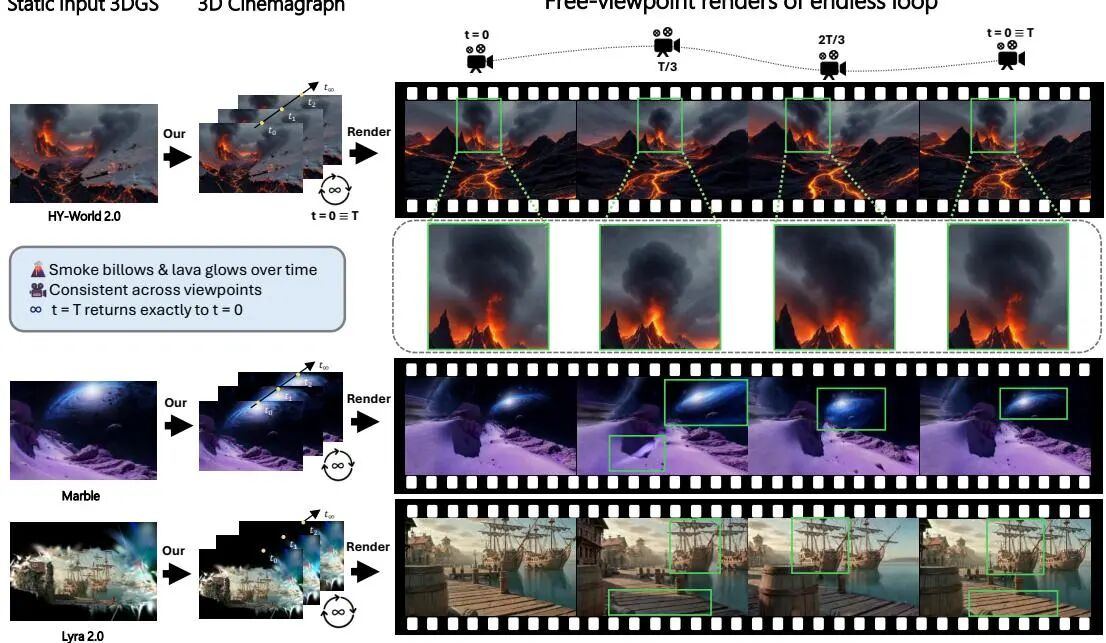
3D世界模型能把一张照片变成可走进去的场景,可这些世界是冻住的:叶子不摇,雾不飘,灯不闪。OuroWorld不用画任何掩膜,让视觉语言模型自己判断什么该动、怎么动,再用傅里叶形变场把首尾严丝合缝地接上。39个场景上全面超越四路基线,30人盲测偏好率70.8%—99%,值得一看它怎么在"互相打架"的脏监督里学出一个干净的4D场景。
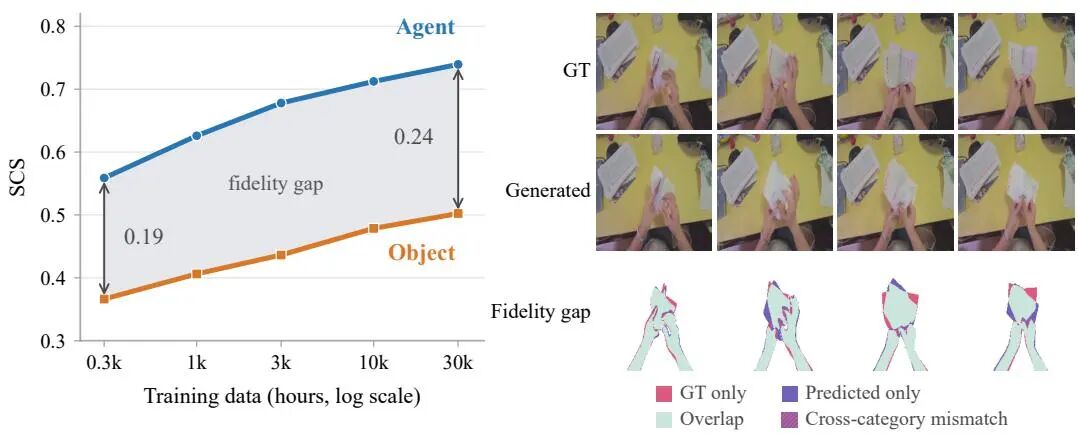
一篇给"数据越大越懂世界"这条信仰做压力测试的论文。丰田研究院联合UIUC、CMU、JHU,拿3万小时第一人称人类操作视频训练世界模型,结果有点扎心:智能体的手放在哪学得又快又准,被它折的那张纸却始终折错。骨架条件化之后,300小时就能顶到基线1.5万小时的水平;而物体交互这条曲线,怎么加数据都抬不起来。作者给出的结论比数据本身更值得读——差距出在训练方式,
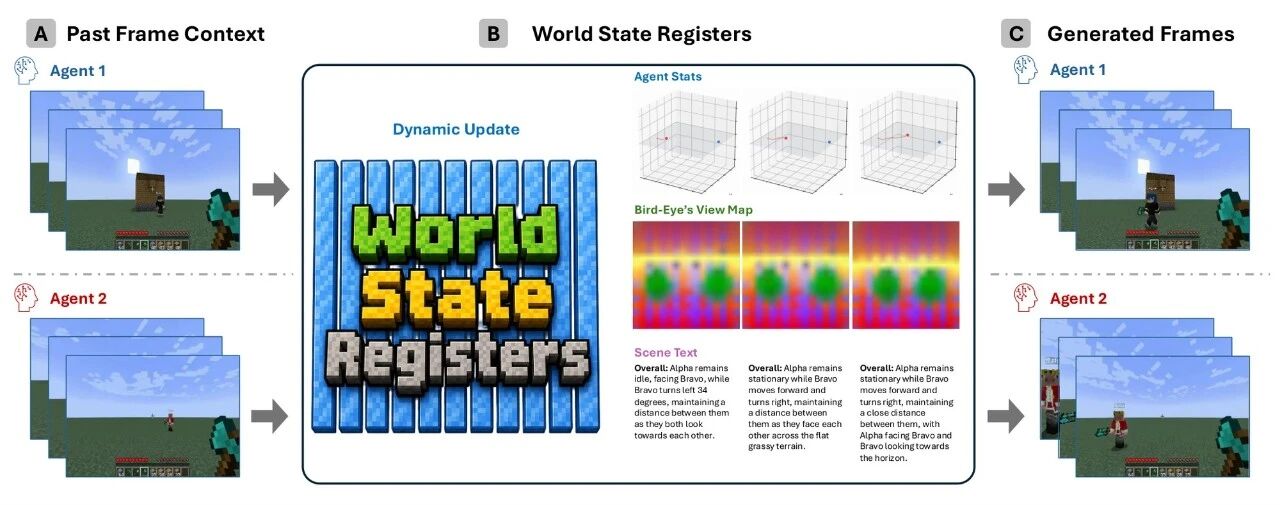
论文基本信息 原文标题: 多智能体自回归扩散模型与世界状态寄存器(Streaming Multi-Agent Autoregressive Diffusion Model with World State Registers) 首次公开: 2026年7月23日 署名单位: 加州大学洛杉矶分校、Adobe Research 原论文: https://arxiv
原文标题: Video DeltaNet: A Video-Native Hybrid Attention for Livestream Video Generation 首次公开: 2026年9月17日 署名单位: 加州大学伯克利分校、Impossible公司、得克萨斯大学奥斯汀分校 原论文: https://arxiv.org/abs/2609.2074
原文标题: Programmable World Model 首次公开: 2026年9月10日 署名单位: Alaya Lab 原论文: https://arxiv.org/abs/2609.10540 项目页: https://alaya-lab.github.io/pwm 开源代码: https://github.com/AlayaLab/pwm
论文基本信息 方法名称: 双阶段内生注意力利用方法(DIAL) 原文标题: Harnessing Intrinsic Subject- Aware Attention for Controllable Multi- Subject Video Generation 首次公开: 2026年9月10日 署名单位: 阿里巴巴集团、北京大学 研究领域: 多主体参考图
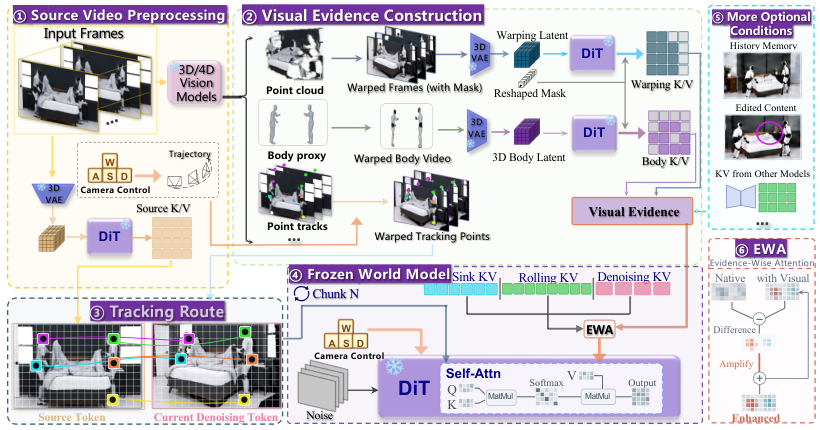
论文基本信息 方法名称: 世界中世界方法(WiW) 原文标题: World in World: Explore the World with World Models 署名单位: 西湖大学智能实验室 首次公开: 2026年9月10日(arXiv v1) 原论文: https://arxiv.org/abs/2609.11548 项目页: https://ch
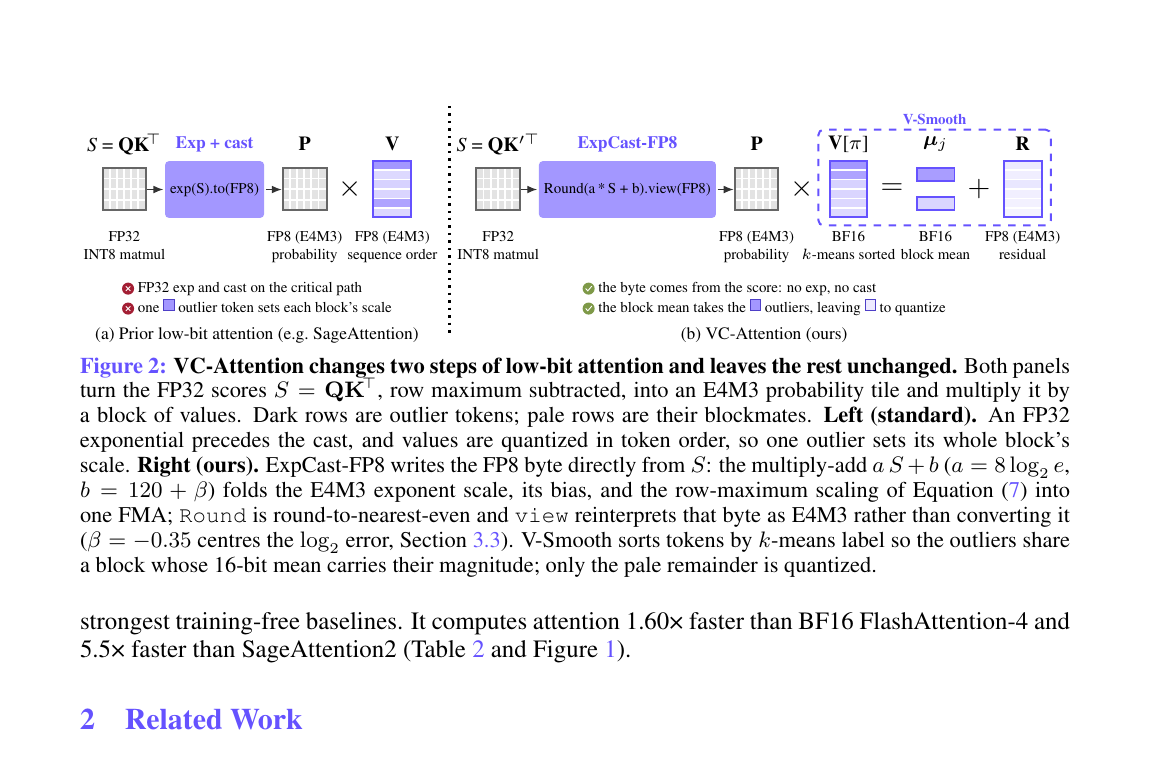
论文基本信息 原文标题: VC-Attention: Value Smoothing and Softmax Casting for Low-bit Attention 首次公开: 2026年9月15日(北京时间;arXiv记录的原始时间为2026-09-14 16:17:35协调世界时) 主要署名单位: Nunchux AI、麻省理工学院、英伟达 合作署名
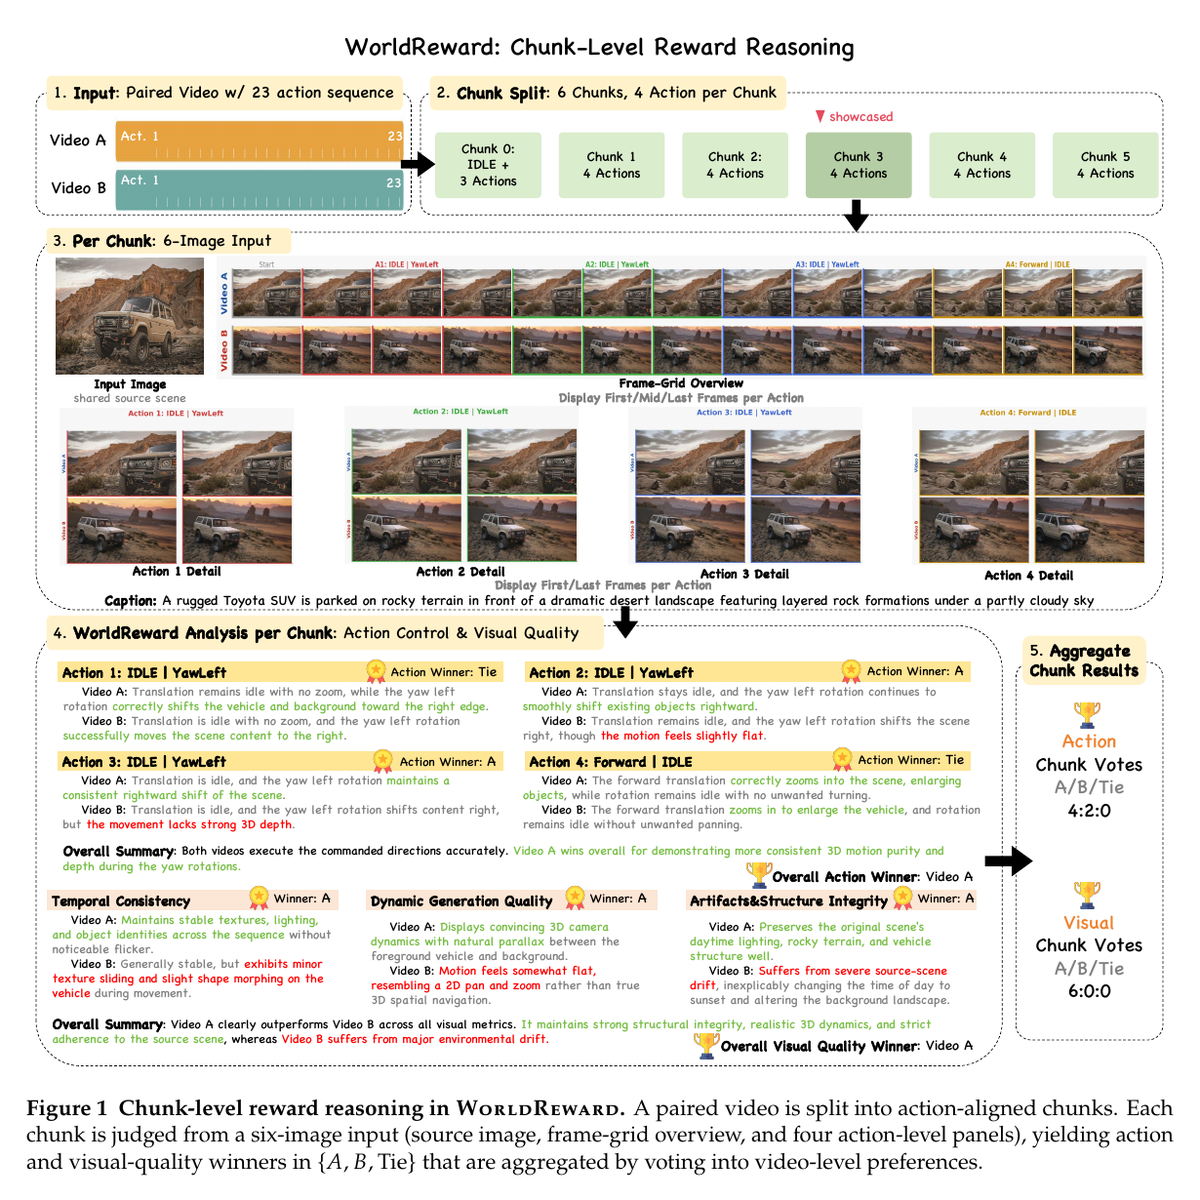
世界模型生成的视频越来越逼真,但它可能一边把画面做得很漂亮,一边悄悄执行错了相机指令。复旦、腾讯混元、上海创智学院、上海交大和上海人工智能实验室等团队提出 WorldReward:不再只看单帧美不美,而是逐段检查“动作有没有做对、画面有没有崩”。在 760 对人工标注视频上,它对动作、外观和运动质量的判断一致率分别达到 77.63%、81.32% 和 73.

如果把短视频推荐系统想象成一家大型仓库,算法的工作就是“在仓库里找一件用户最可能喜欢的东西”。仓库越大,推荐越准。可问题在于:算法再聪明,也只能在仓库里挑,不能在用户最想要的那一刻,照着用户的心思现场做一件出来。

大模型生成视频"看起来美,动起来假"的顽疾有解了。这篇来自四川大学的工作,不去堆算力,而是给视频生成装上"物理事件链"大脑,用可量化的物理公式约束每个中间状态,在PhyGenBench上把物理贴合度均值提升到72.5%,值得做视频生成与世界模型的朋友细读。
LONGGE AI COMMUNITY
加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。
加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。
 微信扫码加入知识星球