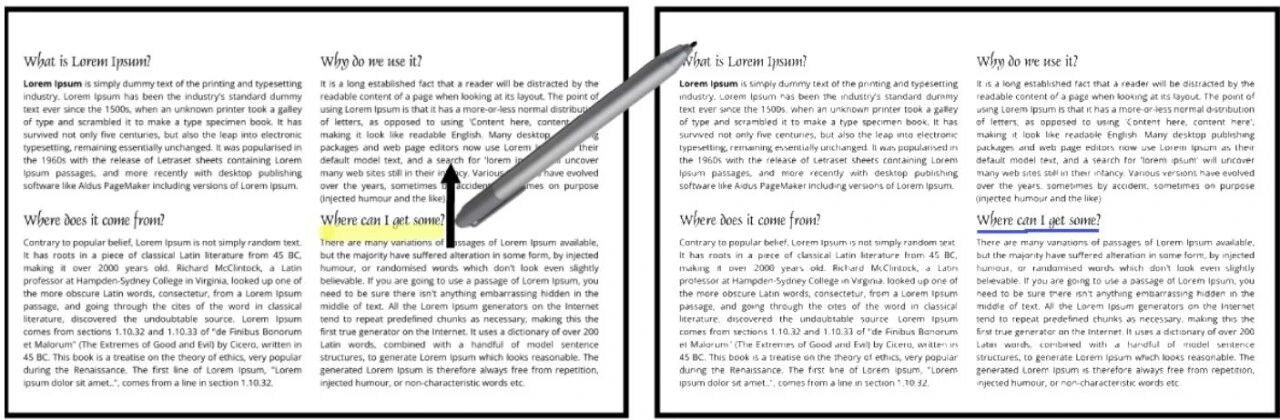
安大略理工×微软:LSTM自动切笔模式,准确率88.55%
数字笔已经普及了很多年,但有一个问题几乎没怎么变过:模式切换。
LONGGE AI RESEARCH DAILY
每天筛选值得关注的 AI 论文,用工程视角拆解方法、实验和真正的落地价值。
目前已发表 1811 篇文章
数字笔已经普及了很多年,但有一个问题几乎没怎么变过:模式切换。
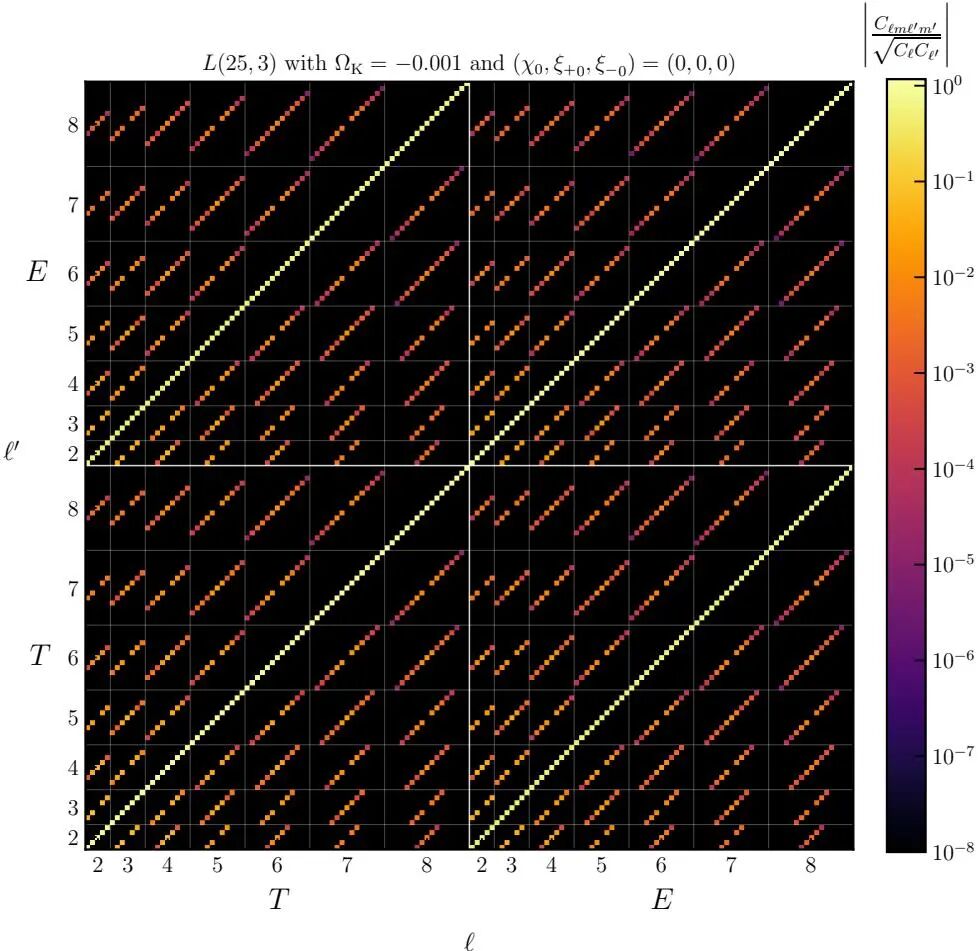
宇宙有没有「重复的走廊」?这篇 COMPACT 合作组的新论文,第一次把任意透镜空间的 CMB 全谐空间协方差矩阵算了出来,包括长期被忽略的非对角项。结论有点反常识:哪怕天上找不到配对圆,拓扑信号仍可能藏在统计结构里,而且能多撑 10%。
先从一个看起来特别朴素的问题开始:往一个带电荷 Z 的原子核旁边塞电子,它最多能"抱住"几个?这里的动词很关键,是"抱住",不是"塞进去"。电子之间互相排斥,塞得越多,最外面那层的电子越容易掉头就跑。
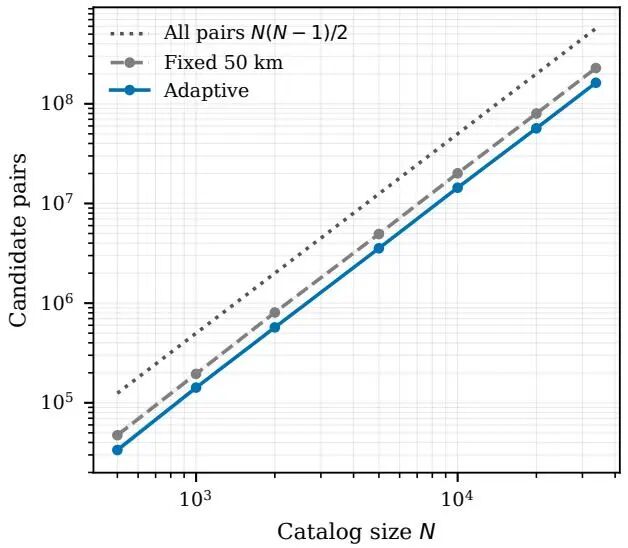
太空越来越挤,几万颗卫星的轨道交会筛选正在变成算力灾难。斯坦福这篇论文不换模型、不堆显卡,只用公开星历历史给每个目标单独估一个不确定度,把固定50公里阈值改成自适应阈值,候选对直接砍掉近三成,扫描速度还快27倍。在算力普遍吃紧的当下,用一次漂亮的"减法"换回大笔计算预算,这种思路值得每个做大规模筛选的人读一读。
一个写进2008年专著、又在2013年被论文重新提出的公开问题,如今拿到了肯定答案:只要自由Abel拓扑群同构,可数紧性就必然同步。全文没有一行实验、没有一张指标表,靠的全是Wallman紧化、超滤子极限和Baire纲定理硬啃下来,纯数学的刀法,值得围观🤨
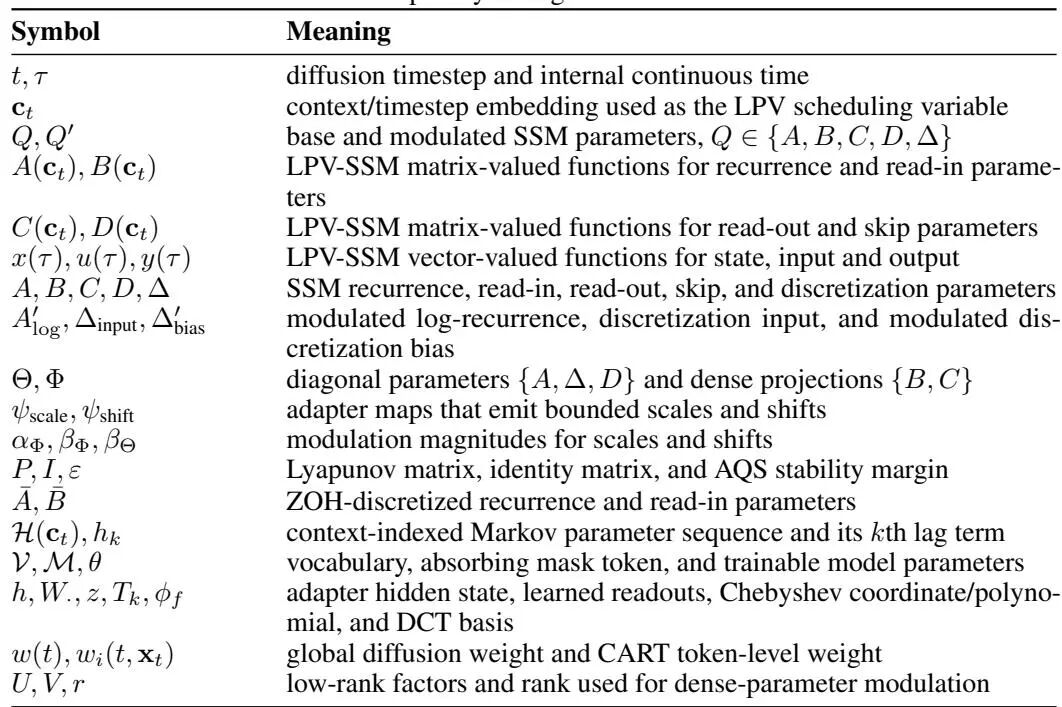
条件化这件事,主流做法要么把上下文塞进输入,要么用AdaLN去调激活,本质都是在外围打补丁。香港城市大学和英伟达AI技术中心这篇,直接把扩散时间步映射成SSM递归参数A、B、C、D、Δ的有界偏移,冻结111M骨干只训6.3到11M适配器,Chebyshev核平均验证损失压到2.55,还附送一份解析稳定性证书。能把"为什么稳"讲清楚的参数高效微调,不太多见,值
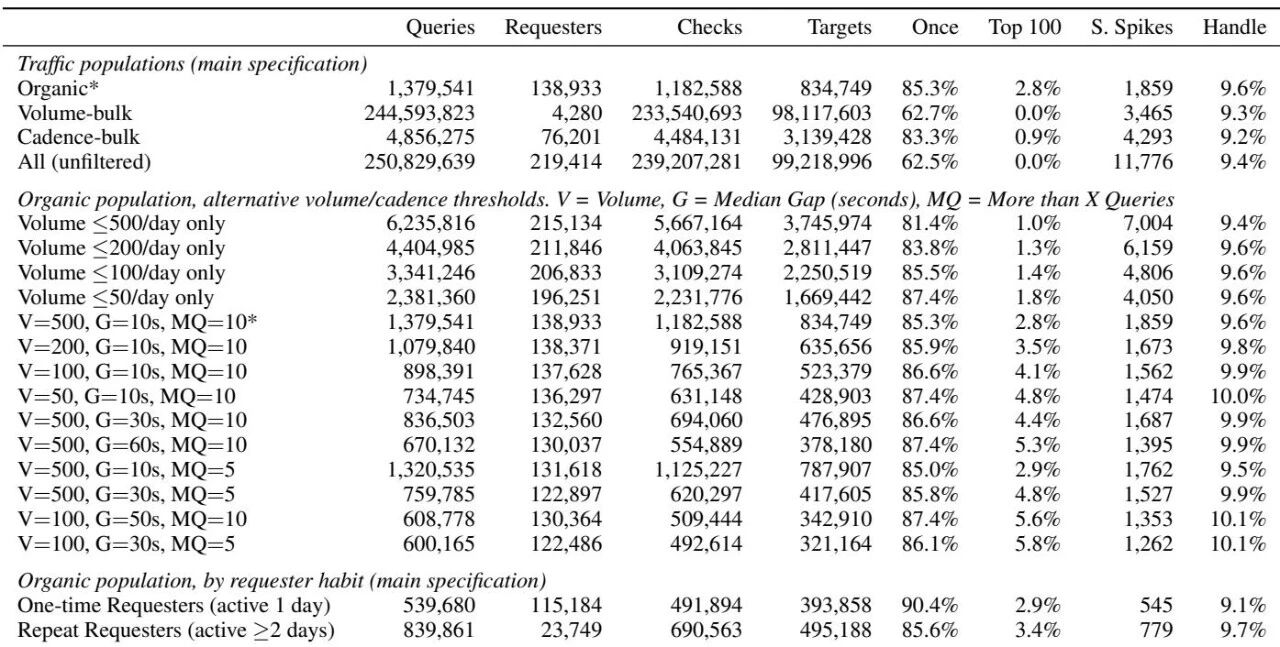
凌晨一点,你刷到一条推文:语法完美、情绪饱满、主页挂着三个外链和一份加密货币白皮书,而且它已经连续发了十四个小时。你盯着屏幕两秒,脑子里冒出一句话:这账号是不是机器人?
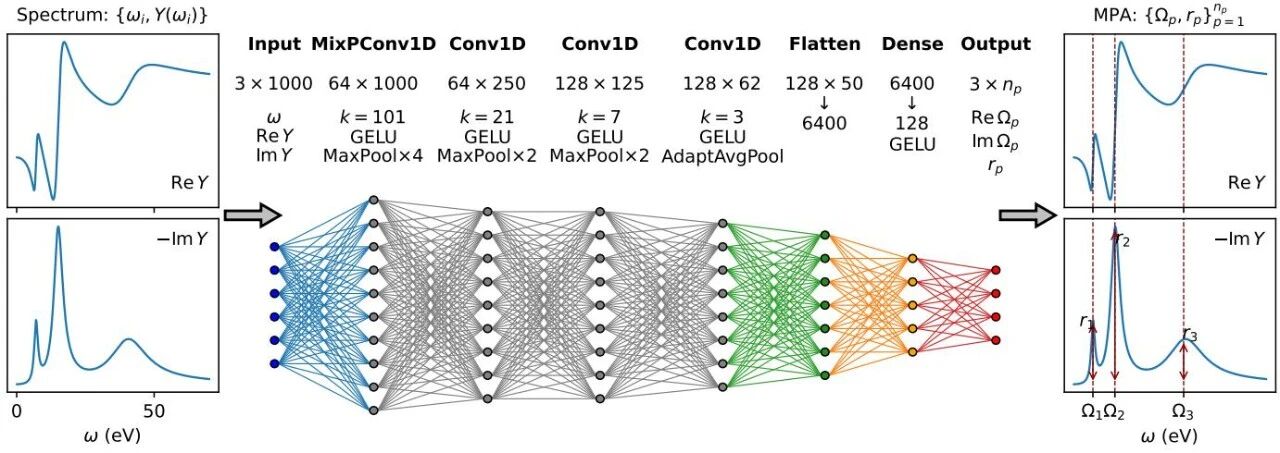
介电谱里藏着等离激元的能量位置和展宽,但传统做法要靠非线性拟合一点点抠,初始化选不好还容易翻车。这篇论文换了个思路:用纯解析公式生成合成谱,让一个约百万参数的卷积网络把反演任务一次性学会,单次前向直接吐出极点参数,全程不碰材料数据库。它到底能不能迁移到真实第一性原理谱和实验谱?边界又在哪里?值得花时间看一眼。
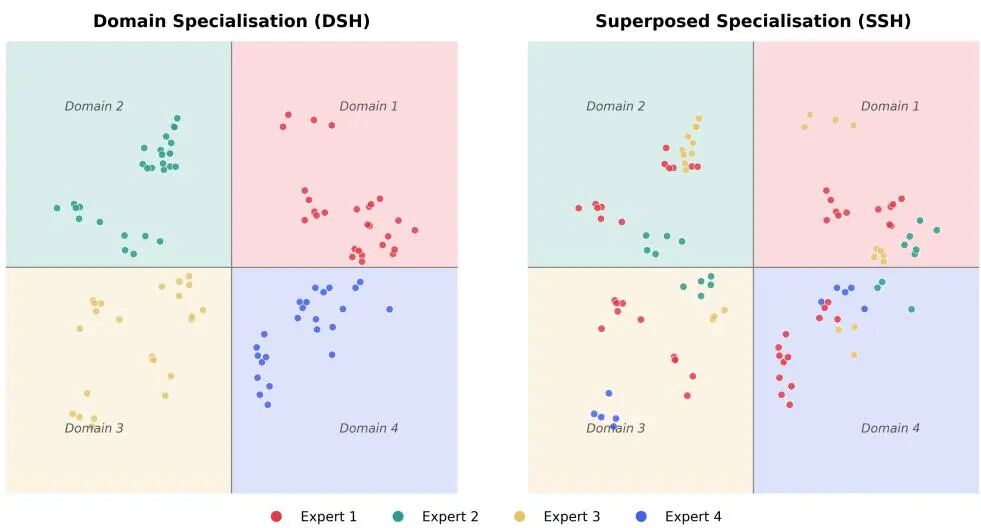
MoE模型火了好几年,可「专家到底在干嘛」一直没人说清。主流解释是每个专家管一个领域,但真去翻,翻不出来。维也纳工大等提出RouterInterp,用稀疏自编码器给出另一种答案:专家干的是「多份不相关特征的叠加活儿」。这个结论有点反直觉,但证据挺扎实。
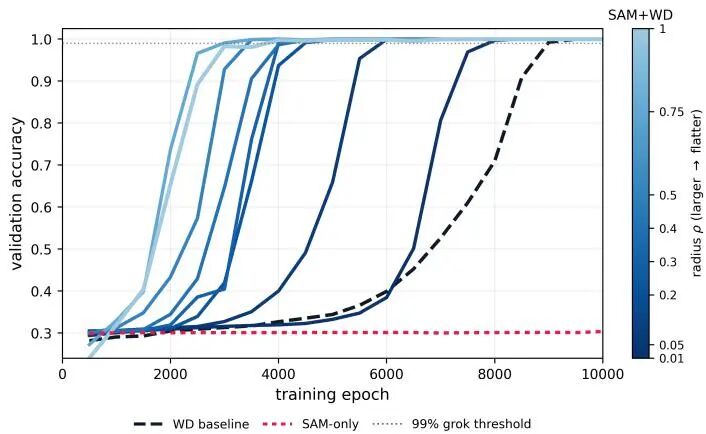
「平坦的最小值更容易泛化」这条被引用了快三十年的经验规律,这次被普渡大学拿出来单独审了一遍。结论有点扎心:用 SAM 硬把解压到最平,模型照样一点儿没泛化;真正把模型从记忆推向泛化的,是权重衰减带来的范数下降,SAM 只是在这个窗口里帮忙踩了一脚油门,把转变加速到最多 4 倍。理论构造那部分尤其漂亮:两种插值的平坦度一模一样,差距全在范数上。
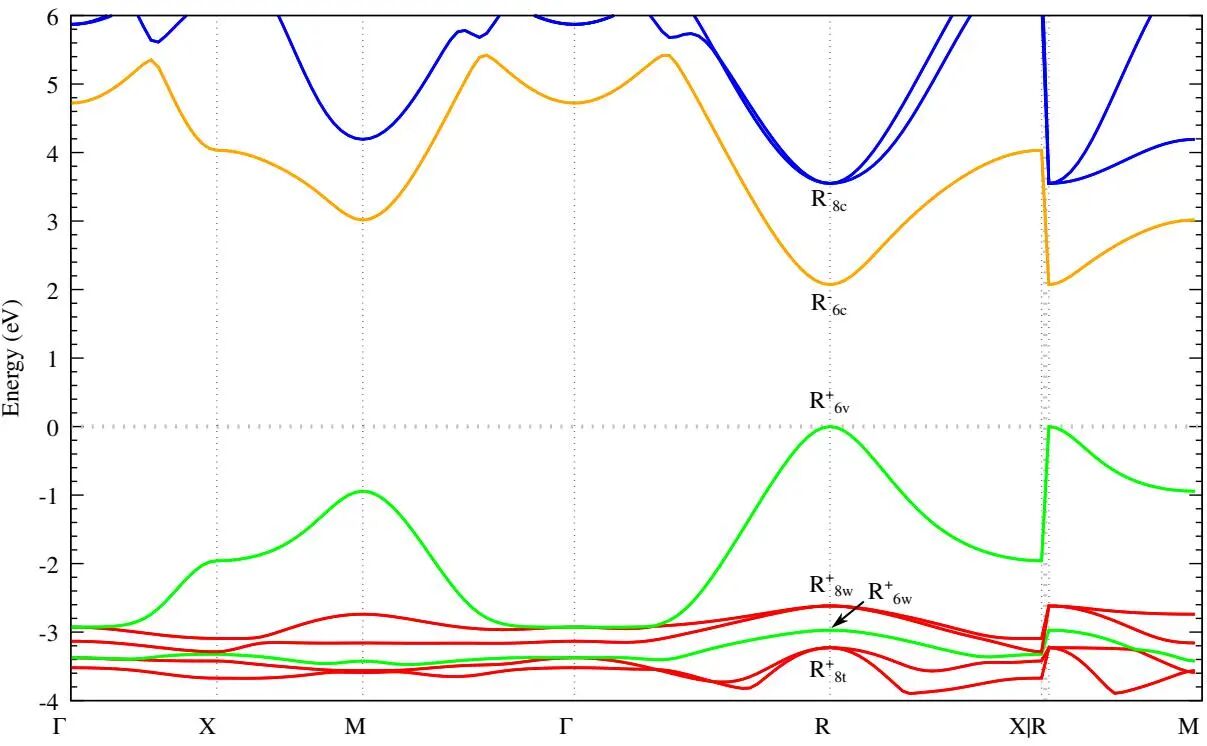
钙钛矿的g因子,平时没人提,但它决定了自旋器件能不能好好用磁场。这篇论文搬出18带k·p模型,说了一句挺实在的话:晶格稍稍一夹,g因子就能大幅变,甚至被调到零;可一旦做成纳米晶,这套把戏就明显不灵了。
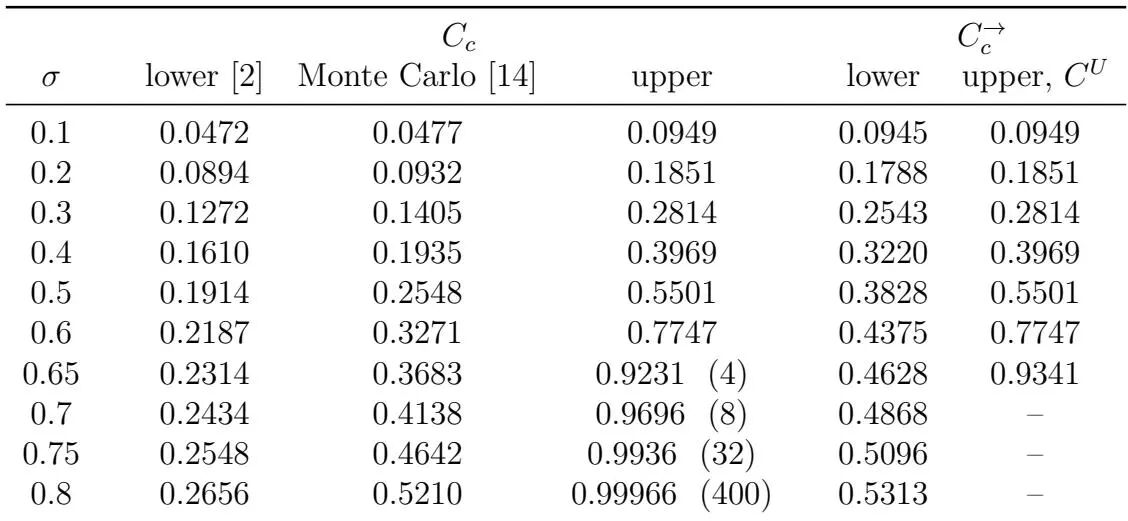
先把场景搭起来。想象一条无限长的直线,整数位置 0、1、2、3……上各坐着一个站点。在一维「键渗流」(bond percolation)模型里,任意两个站点之间都可能连一根「键」,每根键独立地决定自己是开还是关。
LONGGE AI COMMUNITY
加入「龙哥读论文」知识星球,持续获取 AI 论文、资讯、开源项目、招聘与研究思路。
加入龙哥读论文微信群:添加微信 kangjinlonghelper,备注“研究方向 + 地点 + 学校/公司 + 昵称”。
 微信扫码加入知识星球